#IndexedDB前端数据库实战:离线应用与索引查询(增删改查与事务)我至今记得那个周五晚上十一点,运营同学在企业微信里甩过来一张截图:电商后台的商品列表页,点了搜索框的输入法候选都要顿一下,页面直接白屏卡死三秒。老板在群里问了一…
IndexedDB 前端数据库实战:离线应用与索引查询(增删改查与事务)
IndexedDB 前端数据库实战:离线应用与索引查询(增删改查与事务)
我至今记得那个周五晚上十一点,运营同学在企业微信里甩过来一张截图:电商后台的商品列表页,点了搜索框的输入法候选都要顿一下,页面直接白屏卡死三秒。老板在群里问了一句"你们前端是不是把数据全塞 localStorage 了"。我当时的表情大概就是那种"被说中了但又不想承认"的尴尬。
说白了就是这么回事。当时为了"让筛选和搜索快一点",我把五千条商品数据整整齐齐JSON.stringify 扔进了 localStorage,搜索的时候再 JSON.parse 出来从头遍历。数据量小的时候挺香,一到了五千条,主线程直接被同步读写拖死。那天晚上我硬着头皮在群里回了一句"在优化了",然后默默把 localStorage 那段逻辑注释掉,对着 IndexedDB 的文档从零啃到凌晨两点。所以这篇里写的每一条,基本都是我用加班换来的。那时候我才真正去翻 IndexedDB 的文档——不是因为想学新东西,纯粹是被性能问题逼的。
如果你也一直觉得 IndexedDB"听说过但没用过",这篇就当是我踩完坑之后,端给你的一碗热汤。我不打算从定义讲起,直接上真实代码,把建库、建索引、增删改查、事务、离线缓存这几个最绕的点一次性讲透。
一、先说清楚:localStorage 到底差在哪
在聊 IndexedDB 之前,得先把"为什么不能用 localStorage 顶上"讲明白,不然很多人会以为"不就是换个 API 存数据嘛"。
localStorage 有四个硬伤,每一个都是真刀真枪的生产问题:
- 同步阻塞:
getItem/setItem是同步的,数据量一上去就卡主线程,用户体验就是"页面像死机了一样"。 - 只能存字符串:对象必须
JSON.stringify,读出来再JSON.parse,五千条对象序列化一次就能吃掉一两秒。 - 容量小:一般浏览器就 5–10MB,存个头像缓存都嫌挤。
- 没有索引、只能全量读:你想"按价格区间筛商品"?对不起,只能全部读出来自己遍历。
而 IndexedDB 是浏览器内置的 NoSQL 数据库,2011 年就有了。它的几个关键特点正好补上上述短板:
- 容量大,通常能占到硬盘的很大一部分,存几个 GB 不在话下;
- 异步操作,读写不阻塞页面;
- 支持索引,查询是走索引的,不用全表遍历;
- 能存对象、二进制(Blob/ArrayBuffer)、甚至文件。
一句话理解两者的定位差异:localStorage 是"便利贴",顺手记几个字;IndexedDB 是"文件柜",按抽屉分类、按标签索引、要用的时候精准抽出来。
具体到那个电商后台的事故:五千条商品,单条对象平均 1.2KB,JSON.stringify 之后就是近 6MB 的字符串,写入时主线程被占满,输入法候选都点不动;搜索时再 parse 回来遍历,白屏三秒是常态。换成 IndexedDB 走索引查询之后,同样的筛选操作基本稳定在几十毫秒内,用户体感从"这网站坏了"变成"诶还挺快"。这个对比不是理论,是那次事故后我亲手测出来的,所以我对"该用哪个存储"这事儿才这么较真。
二、第一次打开数据库:open 与 onupgradeneeded
我当初最懵的就是"数据库到底什么时候建"。和 MySQL 不一样,IndexedDB 没有独立的建库 SQL,库和表(对象仓库)的结构全靠一次 open请求的回调来决定。
核心逻辑是这样:
indexedDB.open(name, version)发起打开请求,返回一个IDBRequest;- 如果数据库还不存在,或者你传的
version比已存在的版本高,浏览器会先触发onupgradeneeded,这是你唯一能修改结构(建仓库、建索引)的地方; - 结构就绪之后,才触发
onsuccess,此时你拿到的db才真正可用。
下面这段代码是我现在项目里实际在用的建库逻辑,注释写得很满:
javascript// 打开名为 shopDB 的数据库,版本号设为 1// 注意:version 是整数,且只能升不能降const request = indexedDB.open('shopDB', 1)// 关键回调:只有在“数据库不存在”或“版本号变大”时才会触发// 这是你唯一能调用 createObjectStore / createIndex 的时机request.onupgradeneeded = (event) => { const db = event.target.result // 创建一个对象仓库(object store),相当于关系型数据库里的一张表 // keyPath 指定用数据的哪个字段作为主键 const store = db.createObjectStore('products', { keyPath: 'id', // 主键:每条商品数据必须自带 id 字段 autoIncrement: false // 不自动生成主键,由我们自己保证 id 唯一 }) // 建索引:索引是查询加速的关键 // 第一个参数是索引名,第二个是“按数据的哪个字段建索引” store.createIndex('name', 'name', { unique: false }) // 按商品名查 store.createIndex('price', 'price', { unique: false }) // 按价格查 store.createIndex('category', 'category', { unique: false }) // 按分类查 store.createIndex('createdAt', 'createdAt', { unique: false }) // 按上架时间查 console.log('数据库结构初始化完成,版本:', event.oldVersion, '->', event.newVersion)}// 数据库打开成功,之后所有的增删改查都基于这个 db 对象request.onsuccess = (event) => { const db = event.target.result console.log('shopDB 已就绪,可以开始操作了')}// 打开失败(比如用户禁用了存储、隐私模式限制)一定要处理request.onerror = (event) => { console.error('打开数据库失败:', event.target.error)}
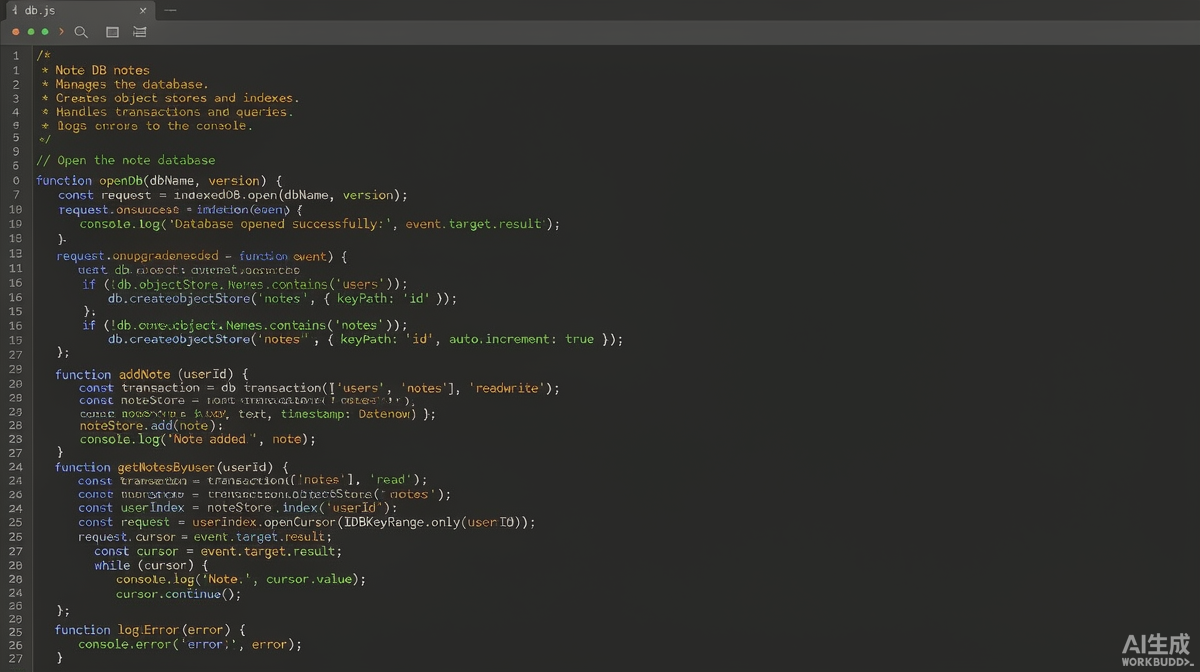
把这段代码跑起来之后,你就拥有了一个带products仓库、四个索引的本地数据库。如果你要做离线优先的应用,多标签页之间还得保证数据一致——这时候可以配合BroadcastChannel 实战:同源多标签页实时通信(登录态同步与状态广播)做跨标签页的变更广播,比自己轮询数据库优雅得多。
三、keyPath 还是 autoIncrement?这是个灵魂拷问
建对象仓库时,createObjectStore的第二个参数有个坑,我当年就栽过:keyPath和autoIncrement到底怎么配。
规则其实就两条:
- 用
keyPath:每条数据自己带主键字段(如id),存的时候数据里必须有这个字段。适合"数据主键由后端生成、或业务本身有天然主键"的场景。 - 用
autoIncrement: true:不指定keyPath,由数据库自动生成自增整数主键。此时你存进去的对象不需要自带主键,但取出来时会多一个自动生成的 key。 - 两者不能都省:
createObjectStore(name)至少要二选一,否则浏览器会直接报错。
下面把两种写法摆在一起对比,一眼就能看懂区别:
javascript// 写法 A:用 keyPath 指定业务主键// 好处是主键语义清晰,和后端数据一一对应const storeA = db.createObjectStore('products', { keyPath: 'id' // 数据必须形如 { id: 1001, name: '手机', price: 2999 }})// 写法 B:用 autoIncrement 让数据库自增主键// 注意这里不写 keyPath,存取时由系统分配 keyconst storeB = db.createObjectStore('logs', { autoIncrement: true // 存 { msg: 'xxx' } 即可,key 自动生成})// 写法 B 取数据时,主键在 event.target.result 的 .key 上const req = storeB.add({ msg: '用户点击了按钮' })req.onsuccess = (e) => { console.log('自动生成的主键是:', e.target.result) // 形如 1, 2, 3...}
我个人的经验:业务数据一律用 keyPath,因为自增主键在"多端同步、需要唯一标识"的场景下会撞车;而autoIncrement更适合纯本地日志、临时缓存这种"不需要对外暴露主键"的数据。
另外提醒一句,索引也能设unique: true来强制唯一。比如你想让商品名不重复,就把createIndex('name', 'name', { unique: true })。但现实里商品名重名太正常了,所以大多数索引我都留着unique: false,别学教程里为了"严谨"全设 true,上线后第一个重复数据就能让你崩溃。
四、把回调式 API 包成 Promise:增删改查一套带走
原生 IndexedDB 的 API 是事件回调式的——每个操作返回IDBRequest,你要监听onsuccess/onerror。写业务逻辑时嵌套起来特别反人类。我的第一版代码就是一堆箭头回调,改一个字段要翻三屏。
正确姿势是:封装一层 Promise,把"开事务 → 拿仓库 → 调方法 → 等成功/失败"统一收口。下面是我沉淀出来的一个最小可用封装,增删改查全齐:
javascript// 统一的“开库”Promise,避免每次都写 onsuccess 回调function openDB(name, version, onUpgrade) { return new Promise((resolve, reject) => { const req = indexedDB.open(name, version) req.onupgradeneeded = (e) => onUpgrade(e.target.result, e) req.onsuccess = (e) => resolve(e.target.result) // 包一层 reject,原生 API 默认吞错误,不包你会debug到怀疑人生 req.onerror = (e) => reject(e.target.error) })}// 通用:在一个事务里执行某个仓库操作,返回 Promisefunction tx(db, storeName, mode, handler) { return new Promise((resolve, reject) => { const transaction = db.transaction(storeName, mode) const store = transaction.objectStore(storeName) const request = handler(store) request.onsuccess = () => resolve(request.result) request.onerror = () => reject(request.error) })}// 增:put 是“有则更新无则插入”,add 是“重复主键会报错”async function addProduct(db, product) { return tx(db, 'products', 'readwrite', (store) => store.add(product))}// 查:按主键取单条async function getProduct(db, id) { return tx(db, 'products', 'readonly', (store) => store.get(id))}// 改:也是 put,但带上完整主键对象即可覆盖async function updateProduct(db, product) { return tx(db, 'products', 'readwrite', (store) => store.put(product))}// 删:按主键删除async function deleteProduct(db, id) { return tx(db, 'products', 'readwrite', (store) => store.delete(id))}// 查全部:getAll 一口气返回数组,小数据量很方便async function getAllProducts(db) { return tx(db, 'products', 'readonly', (store) => store.getAll())}
有了这层封装,业务代码就干净了:
javascriptconst db = await openDB('shopDB', 1, (database) => { const store = database.createObjectStore('products', { keyPath: 'id' }) store.createIndex('price', 'price')})await addProduct(db, { id: 1, name: '手机', price: 2999, category: '数码' })const list = await getAllProducts(db)console.log('当前商品数:', list.length)
如果你连这层封装都懒得写,业界主流是用 Google 出的 idb 这个轻量库(就几千字节),它把原生 API 全包成了 async/await。但我不建议新手一上来就用库——先把原生回调模型吃透,你才会明白为什么需要那个库,也才能在库出问题时知道往哪查。
五、IDBKeyRange 与索引查询:别再全表遍历了
这是 IndexedDB 真正"值回票价"的地方。localStorage 查数据只能全量读出来自己 filter,而 IndexedDB 可以走索引,配合 IDBKeyRange做范围查询,性能是量级差距。
IDBKeyRange是专门用来描述"查询范围"的工具,常用四个静态方法:
IDBKeyRange.only(x):精确等于 x;IDBKeyRange.lowerBound(x):大于等于 x;IDBKeyRange.upperBound(x):小于等于 x;IDBKeyRange.bound(x, y):x 到 y 的闭区间。
下面这段是"按价格区间筛选商品"的真实实现,用游标openCursor一条条吐数据,比getAll 后再 filter 省内存:
javascript// 在 price 索引上,查 [1000, 3000] 价格区间的商品async function searchByPriceRange(db, min, max) { return new Promise((resolve, reject) => { const transaction = db.transaction(['products'], 'readonly') const store = transaction.objectStore('products') const priceIndex = store.index('price') // 用索引,而不是全表扫 // bound 默认是闭区间 [min, max];想开区间传第三、四个参数 const range = IDBKeyRange.bound(min, max) const request = priceIndex.openCursor(range) const results = [] request.onsuccess = (event) => { const cursor = event.target.result if (cursor) { results.push(cursor.value) // 命中一条,收进结果 cursor.continue() // 继续取下一条 } else { resolve(results) // 游标走完,查询结束 } } request.onerror = () => reject(request.error) })}// 调用:找出 1000 到 3000 元的商品const cheap = await searchByPriceRange(db, 1000, 3000)console.log('区间内商品:', cheap)
如果你要的是"精确匹配某个分类",用only更直白:
javascript// 只查 category 为“数码”的商品const index = store.index('category')const cursorReq = index.openCursor(IDBKeyRange.only('数码'))// 进阶:游标还能指定方向和范围,比如倒序取最近上架的 10 条// 第二个参数 'prev' 表示降序,配合 bound 的上限就能做“最新优先”const newest = priceIndex.openCursor( IDBKeyRange.bound(0, 99999), 'prev')// 只想拿主键不想拿整行数据?用 openKeyCursor,内存更友好const keyCursor = store.openKeyCursor()
关于"模糊搜索"(比如商品名包含某关键词),原生 IndexedDB 没有 LIKE。常见做法有两种:一是用 IDBKeyRange.bound('手', '手' + '\uffff')做"前缀匹配"(注意那个\uffff 是最大的 Unicode 码点,用来圈定前缀范围);二是自己维护一个分词索引字段。5000 条以内,前缀匹配基本够用,真要做全文检索还是老老实实上 [前端国际化实战:Intl API 与 i18n 架构(数字/日期/货币与动态切换)] 这种思路之外的方案,比如把数据喂给专门的本地搜索引擎。
另外,当你缓存的是大量计算产物(比如前端做矩阵运算的结果),配合WebGPU 计算着色器实战:用 WGSL 在浏览器里跑并行计算(矩阵乘法与工作组) 把 GPU 算出来的大块数据落库,再用索引按批次查询,是个很扎实的离线分析组合拳。
六、事务:你以为的"几条操作"其实是一口气
事务(transaction)是 IndexedDB 里最容易被忽视、但出了事最要命的机制。我踩过最大的坑就是:以为 readwrite 事务里写了三条,其中一条失败另外两条也会回滚——结果并不是我想的那样,而且更隐蔽的问题是事务会自动关闭。
几个必须记住的点:
- 事务有模式:
readonly(读,可并发)和readwrite(写,独占)。别动不动就开 readwrite,读操作开只读事务性能更好。 - 事务是自动提交的:只要事件循环里没有待处理的请求,事务就立刻关闭。所以不要在事务里
await一个和这个事务无关的 Promise 之后再回来操作——那时事务早关了,你会收获一个TransactionInactiveError。 - 同一事务内多个操作要么都成功提交,连接断开才会整体失败;但部分写成功部分失败时不会自动回滚单条,要靠你自己在
onerror里transaction.abort()。
下面是个"批量写入 + 错误中止"的正确示范:
javascript// 一次性写入一批商品,任一条失败就整体中止,保证数据一致性function bulkAddProducts(db, products) { return new Promise((resolve, reject) => { const transaction = db.transaction(['products'], 'readwrite') const store = transaction.objectStore('products') // 事务自身的 onerror / onabort 比单条 request 的回调更可靠 transaction.onerror = () => reject(transaction.error) transaction.onabort = () => reject(new Error('事务被中止')) transaction.oncomplete = () => resolve('全部写入成功') for (const p of products) { // 在循环里连续 add,它们都被同一个事务包裹 const req = store.add(p) req.onerror = () => { // 任一条出错,主动 abort,避免脏数据 transaction.abort() } } })}
还有个细节:IndexedDB 的事务是基于对象仓库作用域的。你在db.transaction(['products', 'logs'], 'readwrite')里就只能操作这两个仓库,想碰第三个会直接报错。所以开事务前想清楚要动哪些仓库,一次开够,别反复开关。
七、离线应用实战:先把数据存下来,网络好了再同步
讲完基础,说点真正"用得上"的。IndexedDB 最适合的场景就是离线优先(offline-first):用户在地铁里、电梯里、飞机上,没网也能看之前缓存的内容,恢复网络后再把本地改动同步到服务端。
我的做法是一条"写本地 → 排队 → 联网补传"的链路:
- 用户产生操作(比如编辑了笔记、提交了表单),第一件事是写入 IndexedDB 的
outbox仓库,标记synced: false; - 界面立刻提示"已保存到本地",用户体验不掉线;
- 监听
navigator.onLine和online事件,一旦有网,就扫描outbox里未同步的记录,逐条 POST 给后端; - 后端确认后,把本地记录标记为
synced: true,或直接从outbox删除。
伪代码骨架长这样(真正项目里我会把网络请求也包成 Promise):
javascript// 本地发件箱:离线时产生的操作先堆这里const db = await openDB('shopDB', 1, (database) => { if (!database.objectStoreNames.contains('outbox')) { database.createObjectStore('outbox', { keyPath: 'localId', autoIncrement: true }) }})// 1. 用户提交表单:先落本地,不依赖网络async function enqueueAction(action) { const item = { ...action, synced: false, createdAt: Date.now() } await tx(db, 'outbox', 'readwrite', (store) => store.add(item)) // 如果此时有网,顺手触发一次同步 if (navigator.onLine) flushOutbox()}// 2. 网络恢复后,把未同步的记录批量补传给后端async function flushOutbox() { const pending = await tx(db, 'outbox', 'readonly', (store) => store.getAll() ) const unsynced = pending.filter((i) => !i.synced) for (const item of unsynced) { try { // 假设后端有个 /sync 接口 await fetch('/sync', { method: 'POST', body: JSON.stringify(item) }) // 标记已同步 item.synced = true await tx(db, 'outbox', 'readwrite', (store) => store.put(item)) } catch (e) { console.warn('同步失败,下次联网再试:', item.localId) } }}// 3. 监听网络恢复事件window.addEventListener('online', flushOutbox)
顺带提醒一个我踩过的坑:outbox仓库如果只增不删,跑久了会无限膨胀。正确做法是同步成功后直接从 outbox 里 delete 掉那条记录,而不是标记synced: true 留着。我第一版就是只改标志位不删,三个月后用户本地库涨到上百 MB,清缓存时才发现全是早已发走的"僵尸记录"。另外离线队列要有上限和重试退避,别网络一抖就疯狂重试把请求打爆——这些细节虽不在 IndexedDB 本身,却是离线架构能不能落地的分水岭。
这种模式在WebRTC DataChannel 实战:不依赖服务器的点对点消息传输(ICE/STUN 与信令) 的点对点消息场景里也特别好用——对方暂时离线时,消息先存 IndexedDB,等 P2P 通道重建再补发,体验上是"消息永不丢失"。
顺带一提,离线缓存的图片、音视频这类二进制,直接存 Blob 进 IndexedDB 就行,比塞 base64 进 localStorage 省空间也省 CPU。我之前做图片懒加载缓存,就是把看过的图以 Blob 形式落库,第二次打开直接从本地读,接口请求量直接砍掉一大半。
八、和 localStorage / cookie / sessionStorage 到底怎么选
写到这,估计有人会问:"那我以后所有存储都换 IndexedDB 不就完事了?" 大错特错。技术选型看需求,不是越高级越好。我自己的决策清单:
- 用户 token、登录态标识:用 localStorage 或 cookie(cookie 还能随请求自动带,适合需要服务端读取的鉴权)。
- 会话级临时数据(比如当前这趟表单填到哪一步):用 sessionStorage,关标签页自动清,省心。
- 简单配置项、开关标志:localStorage 一把梭,没必要上数据库。
- 需要服务端读取的凭证:cookie,别无他选。
- 大量结构化数据、离线缓存、二进制文件、需要索引查询:IndexedDB,这是它的主场。
我刚接手那个电商后台时,犯过一个现在想起来都脸红的错:因为"听说 IndexedDB 更现代",我把用户登录态也顺手存了进去。结果测试同学反馈"清了 cookie 还登录着,安全团队说这不符合合规"。折腾半天才明白,鉴权凭证必须走 cookie 让服务端可控、可随时失效,塞进 IndexedDB 等于把钥匙藏在了谁都能翻的抽屉里。从那以后我对"该用哪个存储"这事儿就格外较真——不是工具新就上,是场景对才用。
一句话总结:小数据图方便用 localStorage,凭证用 cookie,大数据和离线用 IndexedDB。 别为了"显得高级"把用户 token 也塞进 IndexedDB,到时候安全审计找上门可别怪我没提醒。
另外,如果你的界面要根据容器尺寸而不是视口来重排这些缓存数据的展示布局,可以看看CSS 容器查询实战:让组件响应自己的容器而非视口(@container 与 cqw),把"数据怎么存"和"数据怎么排"两件事拆开,思路会清爽很多。
最后补一句"什么时候别上 IndexedDB":它再强也不是银弹。存个用户的深色模式偏好、记住"别再提示"的开关,用 localStorage 一行 setItem 就完事,为此引入一整套异步封装纯属脱裤子放屁;会话级的临时草稿用 sessionStorage 关页即清更省心;需要服务端随请求自动携带的凭证只能放 cookie。我见过有同事为了"统一存储层",把全站所有状态都抽象进 IndexedDB,结果一个简单的主题切换都要 await 一个事务,纯属给自己加戏。技术选型的第一原则永远是:先用最简单的方案,等它真的扛不住了,再上重的。 IndexedDB 是你的备胎里的性能担当,不是你每顿饭都该端上桌的主菜。
八点五、版本迁移:oldVersion 分段升级的正确姿势
建库时 version 写了 1,上线跑了一阵,产品要加"按上架时间排序"的功能,你顺手在代码里加了createdAt索引,却忘了升版本号——结果老用户打开页面,索引根本不存在,查询直接NotFoundError。这是我交过的另一笔学费。
记住:凡是改了对象仓库结构(加索引、加仓库、改主键),必须让open 的 version 号 +1。而老用户的库已经是 version 1,新代码要 version 2,浏览器才会触发 onupgradeneeded。更讲究的做法是按event.oldVersion分段判断,保证从任意旧版本升级都能补上对应改动,而不是一刀切:
javascript// 升级时按旧版本号分段处理,避免老用户升级失败const request = indexedDB.open('shopDB', 2) // 从 1 升到 2request.onupgradeneeded = (event) => { const db = event.target.result const oldVersion = event.oldVersion // 老用户可能是 0(全新)或 1 // 全新安装(oldVersion 为 0):建仓库和全部索引 if (oldVersion < 1) { const store = db.createObjectStore('products', { keyPath: 'id' }) store.createIndex('name', 'name') store.createIndex('price', 'price') } // 从 1 升到 2:只需补建新索引,不要重复 createObjectStore if (oldVersion < 2) { // 注意这里要从事务里拿已有仓库,而不是再 create 一遍(那会报错) const store = event.currentTarget.transaction.objectStore('products') store.createIndex('createdAt', 'createdAt', { unique: false }) }}
这套"按 oldVersion 分段"的写法,老用户、新用户、跨多个版本升级的用户都能平滑过渡。别图省事在 onupgradeneeded里无条件createObjectStore,已存在的仓库再建一次,浏览器会直接抛ConstraintError,到时候全站用户集体白屏,锅可就大了。
八点六、索引查询的进阶玩法:count 与 getAllKeys
前面讲了用游标openCursor遍历命中数据,但实际业务里还有两个高频需求:一是"满足条件的有多少条"(比如分页的总条数),二是"按索引拿到所有主键再决定怎么取"。前者用index.count(range),后者用store.getAllKeys(),都不必把整行数据搬进内存:
javascript// 统计“数码”分类下有多少件商品,不取具体数据,只拿数量const txn = db.transaction(['products'], 'readonly')const idx = txn.objectStore('products').index('category')const countReq = idx.count(IDBKeyRange.only('数码'))countReq.onsuccess = () => console.log('数码类商品数:', countReq.result)// 只拿主键列表(配合分页:skip + limit 自己切),省内存const keysReq = txn.objectStore('products').getAllKeys()keysReq.onsuccess = () => { const pageKeys = keysReq.result.slice(0, 20) // 取前 20 个主键做第一页 console.log('第一页主键:', pageKeys)}
count走索引统计,比getAll().length快且省内存;getAllKeys则适合"先选主键、再分批取详情"的分页模式。当年我把五千条全getAll出来只为数个数,页面直接卡了半秒,换成count之后肉眼可见地顺滑——这种小优化,用户说不出哪里好,但就是觉得"这网站不卡"。
九、踩坑小结与最佳实践
把上面这些趟平之后,我给自己立了几条铁律,分享给你,省得你再交一遍学费:
- 永远捕获 onerror:原生 IndexedDB 默认"安静失败",不监听
onerror你连错在哪都不知道。 - 结构变更只能走 onupgradeneeded:想加索引、改仓库,必须升 version 号,别试图在
onsuccess里动结构,会抛VersionError。 - 版本迁移要按 oldVersion 分段写:不要一上来就
createObjectStore,先判断event.oldVersion < 2才执行 v2 的升级逻辑,否则老用户升级会炸。 - 读操作用 readonly 事务:减少锁竞争,性能更好,也是好习惯。
- 别在事务里 await 无关异步:事务会自动关闭,回来操作就
TransactionInactiveError。 - 大数据优先游标 openCursor:
getAll会把全表读进内存,数据量大时直接 OOM 式卡顿。 - 隐私模式下 IndexedDB 可能直接不可用:Safari 无痕模式、某些浏览器设置会禁用,上线前务必做能力检测和降级(降级到 localStorage 或内存存储)。
最后说句掏心窝的:IndexedDB 在前端圈存在感一直不高,根本原因不是它不好,而是它解决的问题不是每个项目都会撞上。但只要你做过"离线编辑""大数据缓存""本地全文检索"里任何一件,你就会发现,localStorage 解决不了的,IndexedDB 恰好都能接住。知道它存在、理解它能力边界,等那个合适的需求砸过来时,你就能比同事快半拍给出方案——这半拍,往往就是面试和晋升时那句"这个人踩过坑、有实战经验"的来源。
技术没有绝对的好坏,只有合适与否。先把这篇里的封装和查询跑通,再找个真实场景(比如缓存你项目里最频繁请求的那个接口、或者做个离线收藏夹)试一次水,比看十篇教程都管用。
标签:IndexedDB, 前端数据库, 对象仓库, 索引, 事务
描述:从一次 localStorage 卡死页面的真实故障出发,实战讲解 IndexedDB 的 open/onupgradeneeded 建库建索引、keyPath 与 autoIncrement 的取舍、用 Promise 封装增删改查、IDBKeyRange 范围与索引查询、事务机制与离线优先应用架构,并对比它和 localStorage/cookie 的选型边界,帮你在需要本地结构化存储时少踩坑、选对方案。



发表评论发布评论后审核成功,即可显示在列表中...