#WebSerialAPI实战:在浏览器里直接读写串口与硬件设备(requestPort与数据流收发)上个月被一个需求折腾得够呛。工厂那边有个设备管理后台,说白了就是想在网页上直接读一台串口电子秤的重量,顺便给下位机发几条控制…
Web Serial API 实战:在浏览器里直接读写串口与硬件设备(requestPort 与数据流收发)
Web Serial API 实战:在浏览器里直接读写串口与硬件设备(requestPort 与数据流收发)
上个月被一个需求折腾得够呛。工厂那边有个设备管理后台,说白了就是想在网页上直接读一台串口电子秤的重量,顺便给下位机发几条控制指令。我一开始还想当然,觉得这不就是装个串口助手的事儿吗?结果甲方明确说了:不让装任何本地软件,打开网页就能用,还要能嵌到他们现有的后台系统里。
我当时心里咯噔一下。网页读串口?这不是得靠 Electron 打包,或者写个本地代理程序转发吗?后来翻了一圈资料,才发现浏览器其实早就把这事儿给办了——就是 Web Serial API。真跑通之后回过头看,从"网页根本碰不到硬件"到"打开页面就能读写串口",这个门槛的下降是实打实的。但踩的坑也是一个没少,今天就把这整个过程捋一遍。
先说清楚:为什么前端会碰上串口
我猜很多人第一次听说 Web Serial API,反应跟我一样:前端不是只管页面渲染和调接口吗,怎么跟串口扯上关系了?
其实需求从来都在,只是以前被绕过去了。工厂的设备管理后台、实验室的仪器数据采集、3D 打印机的控制页面,还有自助设备上挂的那台小票打印机——这些场景里,设备多半走的是串口(或者 USB 转串口)。过去要让它跟网页对话,就两条路:要么装一个本地代理程序,浏览器通过 HTTP 或 WebSocket 跟代理聊,代理再去读写串口;要么干脆把整个界面做成 Electron 应用,把 Node.js 那套 serialport 能力打进包里。
这两条路我都是踩过的。本地代理的问题是每台机器都得装、都得升级,运维能把人逼疯;Electron 更重,改一行页面代码都得重新打包分发。所以当我知道浏览器原生就能开串口的时候,第一反应是:这玩意儿要是靠谱,能省掉一大半破事。
它确实靠谱,但不是万能的。串口通信本身那些硬骨头——分帧、校验、异常恢复——一个都没因为换了浏览器就消失。这点后面会重点讲,也是这篇文章真正想说的东西。
顺便提一句,这种"把系统级能力开放给网页"的路子现在越来越多了。之前写Media Session API 实战:让网页音频接管锁屏与车载控制面板(元数据与播放控制) 的时候我就感慨过,浏览器正一点点把手伸到操作系统那一层。Web Serial API 是同一个思路,只不过这次伸向的是硬件。
串口通信到底是个啥,先把地基打稳
我发现很多人(包括当初的我)上来就抄代码,结果设备连上了、数据全是乱码,根源就是串口那点基本概念没搞清楚。所以这里先花点篇幅把地基补上,别嫌啰嗦。
串口通信,说白了就是数据一位一位地在单根线上排队传输。跟它相对的是并行通信——并行是一次性用八根线把一个字节的八位同时送出去。串口只有一根线,传一个字节得传八次,慢是慢了点,但胜在简单、抗干扰、线少,所以工业设备用了几十年还是它。
串口通信按数据传送方向分三种。单工,只能单向传,跟广播一样;半双工,能双向传但同一时刻只能朝一个方向,得切换;全双工,两个方向同时传互不干扰,靠的是独立的收发线。我们平时接触的 USB 转串口、单片机 UART,基本都是全双工。
再按通信方式分,同步和异步。同步通信带一根时钟线,双方踩着同一个节拍走,SPI、I2C 就是这类;异步通信没有时钟线,靠双方事先约定好的速率对齐,UART 是典型。这里就引出一个至关重要的参数——波特率。
波特率决定了每一位数据在线上待多长时间。常见的值有 9600、19200、115200。有个细节千万记住:收发双方的波特率必须完全一致,否则你发的是 115200,对面按 9600 去采,采出来的就是一堆毫无意义的字节。我第一版代码乱码,就是因为电子秤出厂默认是 9600,我图省事写了个 115200。这种错误特别低级,但真的非常常见。
除了波特率,还有数据位、停止位、校验位这几个参数。绝大多数设备出厂默认是 8 个数据位、无校验、1 个停止位,也就是行话里的 8-N-1。Web Serial API 的 port.open() 不传这些参数时,默认值刚好就是 8-N-1,所以很多时候你只写个波特率就能通。但一旦设备要求奇校验或者两位停止位,就得老老实实配上,不然照样乱码。
核心模型:三个角色而已
把串口那点概念理顺之后,Web Serial API 本身其实特别薄。我把它拆成三个角色来理解,一下就清晰了。
第一个角色是navigator.serial,这是入口。它负责列举系统里的串口、请求用户授权连接新设备、监听设备的插入和拔出。你可以用'serial' in navigator判断当前浏览器支不支持。
第二个角色是SerialPort,也就是端口对象。拿到它之后调open()打开,配置波特率那些参数。打开成功,这个端口才会暴露出读写能力。
第三个角色是port.readable和port.writable,这是两个流——一个读流,一个写流,所有跟设备的数据交互都在这俩上面做。
这里有个设计我很喜欢:Web Serial API 没有沿用传统那种"读缓冲区 / 写缓冲区"的命令式模型,而是直接把串口数据抽象成了 Web Streams。这意味着它能跟 Web Streams 生态里的其他工具组合,比如用 pipeTo把串口数据直接接到一个解码流、甚至接到网络流做远程转发。这个抽象在工程上是很舒服的。
把第一条数据跑通
理论说完了,先上一段最小可运行的代码,把整个流程串起来。这段代码我按真实项目的写法组织了,注释也标得比较细。
js// 能力检测:先确认浏览器支持 Web Serial APIif (!('serial' in navigator)) { throw new Error('当前浏览器不支持 Web Serial API,换 Chrome 或 Edge');}let port = null;let reader = null;// 连接动作必须绑定在用户手势里,比如按钮点击async function connect() { try { // requestPort 会弹出浏览器自带的设备选择框,用户手动挑一个串口 port = await navigator.serial.requestPort(); // 打开端口,baudRate 必须和设备实际波特率一致(这里是 115200) await port.open({ baudRate: 115200 }); // 从 readable 流拿到读取器,准备持续收数据 reader = port.readable.getReader(); const decoder = new TextDecoder(); // Uint8Array -> 字符串 while (true) { const { value, done } = await reader.read(); if (done) break; // 流被关闭,退出循环 if (value) console.log('收到:', decoder.decode(value)); } } catch (err) { console.error('连接失败:', err.message); }}// 写入数据:串口只认字节,必须用 TextEncoder 编码async function send(text) { const writer = port.writable.getWriter(); await writer.write(new TextEncoder().encode(text + '\r\n')); writer.releaseLock(); // 用完一定释放锁,否则端口会被占用}// 关闭:先取消读取,再关端口async function disconnect() { if (reader) { await reader.cancel(); reader.releaseLock(); } if (port) await port.close();}
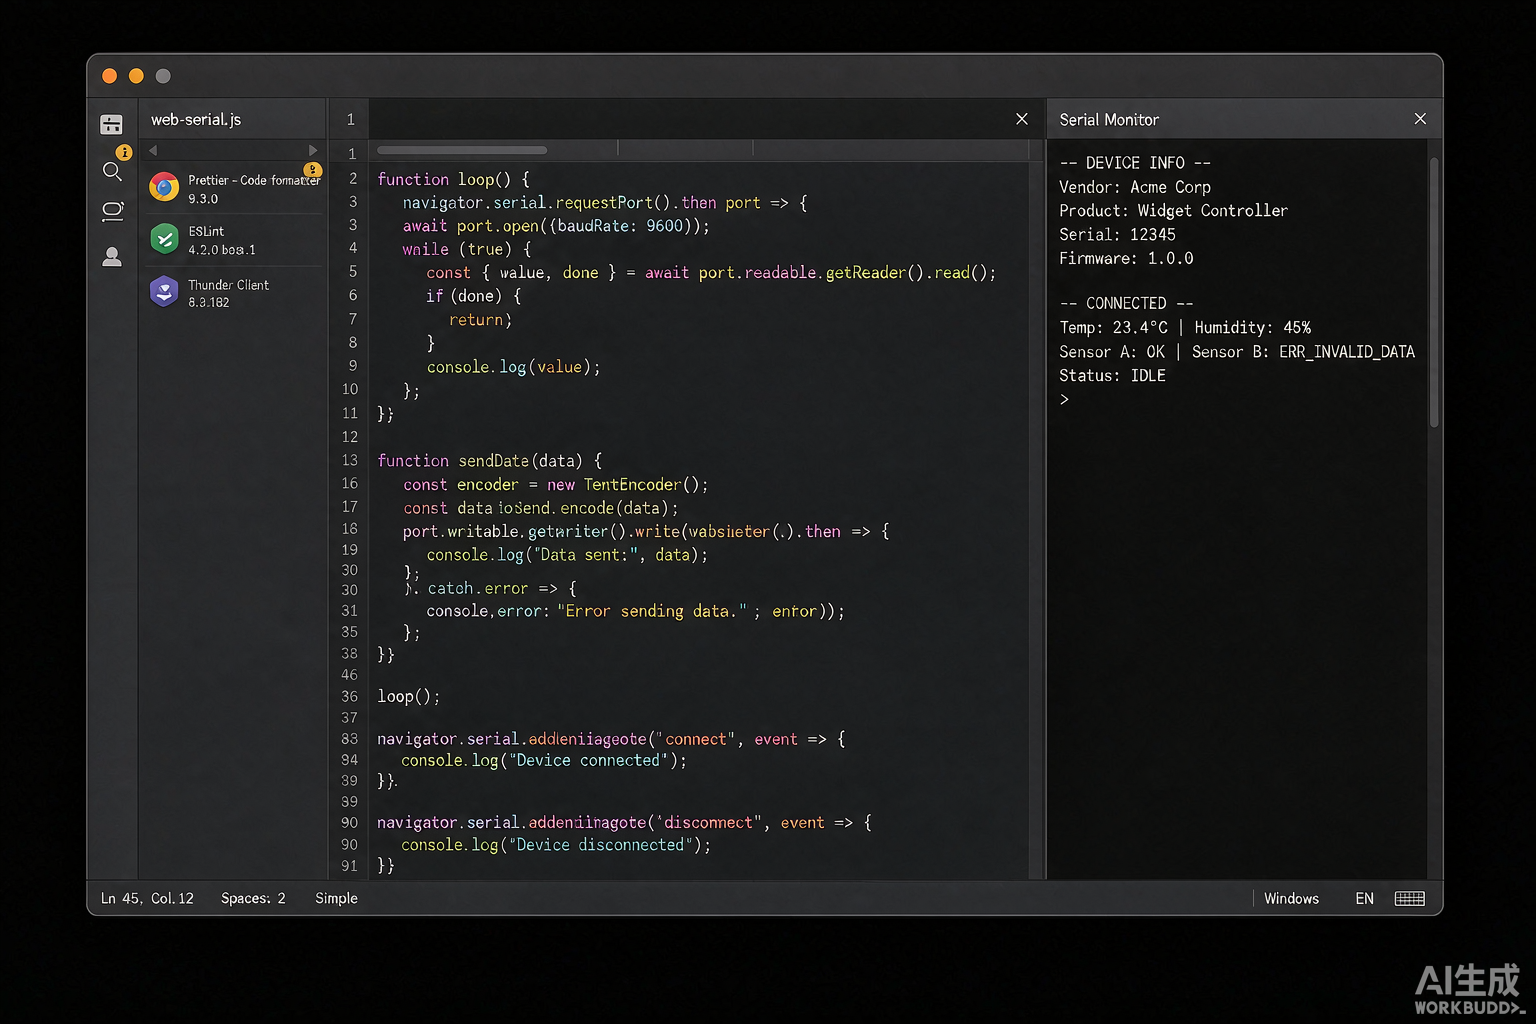
这段代码里有几个点必须拎出来说,都是我当时实打实撞上去的。
第一,requestPort() 必须由用户手势触发。它是绑在按钮的 click 事件里的,你要是想在页面加载完就自动弹出设备选择框,浏览器会直接拒绝。这跟 WebAuthn 与 Passkey 实战:用浏览器原生无密码登录(公钥认证与替代短信验证码的完整流程)里那个"必须用户点一下才能发起认证"的约束是同一个道理——凡是涉及硬件或凭据的敏感操作,浏览器都要求有明确的用户意图,防止脚本在后台偷偷搞事。所以别费劲想绕过它,老老实实做个"连接设备"按钮。
第二,writer.releaseLock()不能忘。写流和读流都是带锁的,你getWriter()拿了写锁,用完不释放,这把锁就一直攥着,下次再写或者关端口都会报错。我一开始就是漏了这句,第一次发指令正常,第二次就抛InvalidStateError,查了半天才定位到是锁没放。
第三,reader.read()返回的对象里,value是Uint8Array,不是字符串,所以得用TextDecoder解码。反过来,写入时用TextEncoder 编码,因为串口设备根本不认识 JavaScript 字符串,它只收字节序列。很多新手第一次调不通,八成就是卡在这一步——直接把字符串塞进 writer.write(),设备那边收到的是乱码或者干脆没反应。
读数据真正的坑:半包和粘包
跑通上面那段代码可能就十几分钟,但别急着高兴,那只是"能收到字节"而已。真正让人掉头发的是接下来这个:串口是字节流协议,它没有消息边界。
啥意思呢?HTTP 一条请求一条响应,边界清清楚楚。串口不是,它就是一股脑往外吐字节。你在循环里 read() 一次,可能只收到半条指令(这叫半包),也可能一次收到三条响应粘在一起(这叫粘包)。你要是天真地以为"一次 read 就是一条完整消息",解析逻辑迟早崩。
比较省事的做法是跟设备约定以换行符结尾。设备每输出一行算一条完整消息,前端维护一个缓冲区,把收到的字节不断追加进去,然后找换行符,找到就切一行出来交给上层。我给你看个处理半包粘包的写法:
js// 处理串口字节流的半包 / 粘包:按换行符切分完整帧const decoder = new TextDecoder();let buffer = ''; // 跨多次 read 残留的缓冲区function handleLine(line) { console.log('一条完整消息:', line); // 这里接自己的业务解析,比如 JSON.parse 或按协议拆字段}async function readWithFraming(reader) { while (true) { const { value, done } = await reader.read(); if (done) break; // 追加到缓冲区,注意串口可能一次只来半行 buffer += decoder.decode(value, { stream: true }); let idx; // 循环切分,一次 read 里可能粘了多行 while ((idx = buffer.indexOf('\n')) !== -1) { const line = buffer.slice(0, idx).trim(); buffer = buffer.slice(idx + 1); if (line) handleLine(line); } } // 流结束后,缓冲区里可能还剩最后半行,别丢掉 if (buffer.trim()) handleLine(buffer.trim());}
这段的关键在decoder.decode(value, { stream: true })。这个stream: true 参数很多人不知道,它的作用是告诉解码器"这是流式中途的一块,多字节字符可能被切开,先别急着吐出来,攒着"。要是没有它,碰上中文这种多字节字符,正好卡在两个 chunk 之间被截断,解码出来就是乱码。我吃过这个亏,一个中文设备名隔三差五变问号,最后才发现是这里少了参数。
还有个细节:read() 是阻塞的。你调一次,它会一直等到有数据或者流关闭才 resolve。所以必须用 while (true)起一个持续的消费循环,让它在后台一直跑。要是只调一次就不管了,设备后面吐的数据全积压在缓冲区里,越堆越多。这也是为什么我把它单独拆成一个异步函数,让它自己跑,不阻塞按钮点击那些交互。
如果你想省事,还可以用TextDecoderStream配合pipeTo,让浏览器直接帮你把字节流转成字符串流:
js// 用 TextDecoderStream + pipeTo 把字节流直接转成字符串流const decoderStream = new TextDecoderStream();// readable 管道接到解码流的 writable,返回的是管道完成的 Promiseconst inputDone = port.readable.pipeTo(decoderStream.writable);const inputReader = decoderStream.readable.getReader();while (true) { const { value, done } = await inputReader.read(); if (done) break; console.log('解码后的一块:', value); // 这里已经是字符串了}
这种写法代码更短,而且天然接上了 Web Streams 的背压机制——消费方处理不过来时,数据会在流里排队而不是把内存撑爆。不过要注意,一旦用了 pipeTo,原本的port.readable就被锁住了,同一时间不能再对它getReader(),想读得从decoderStream.readable这头读。
写数据:发得出去不等于对方收到
写入本身不难,getWriter()然后write()就完事了。但真实场景里,"我把指令发出去了"和"设备确实执行了"是两码事。你得等设备的应答,而串口没有任何机制保证对方一定回你。
我打个比方。你问设备"现在重量多少",它可能 50 毫秒就回,也可能因为故障直接装死。HTTP 有现成的 timeout,串口没有。所以收发逻辑得做成一个小状态机:发出指令后启动一个定时器,收到预期应答就清掉定时器,超时了就得处理——重试或者往上抛错。
js// 带超时的"问一句、等一句"封装:避免一条指令把页面挂死function queryWithTimeout(port, command, matcher, timeoutMs = 3000) { return new Promise(async (resolve, reject) => { const writer = port.writable.getWriter(); const reader = port.readable.getReader(); const decoder = new TextDecoder(); let settled = false; // 超时定时器:到点还没匹配到应答就拒绝 const timer = setTimeout(() => { if (settled) return; settled = true; reject(new Error('设备应答超时:' + command)); }, timeoutMs); try { await writer.write(new TextEncoder().encode(command + '\r\n')); while (!settled) { const { value, done } = await reader.read(); if (done) break; const text = decoder.decode(value, { stream: true }); // matcher 判断这段响应是不是我们要的那条 if (matcher(text)) { settled = true; clearTimeout(timer); resolve(text); break; } } } catch (err) { clearTimeout(timer); reject(err); } finally { writer.releaseLock(); reader.releaseLock(); // 无论成败都释放锁 } });}
这里有个经验之谈:别一上来就追求什么指数退避、自动重试三次那种复杂算法。第一步的目标很简单——保证任何一条指令都不会让页面永久挂起。把最朴素的超时计时器先跑起来,超时就报错让上层知道,单条指令挂不死整个页面。等上线跑一段时间,摸清了设备实际的响应时长,再回头调阈值、加重试策略,这个顺序才对。一开始就写一堆花哨的重试逻辑,反而容易把简单问题复杂化。
设备拔了怎么办:断线恢复必须完整
串口设备的物理连接从来就不可靠。用户随手拔了 USB 转串口的线、设备断电、甚至线材老化接触不良——这些都会让 reader.read()当场抛异常,端口直接进入断开状态。你不处理,读取循环直接崩,用户看到的就是页面假死。
正确做法是两边都兜住:一边注册disconnect 事件监听,一边用 try/catch 把整个读取循环包起来。
js// 监听设备断开,并给读取循环加保护port.addEventListener('disconnect', () => { console.warn('设备已拔出,端口断开'); // 在这里清理状态、更新界面提示用户重新插入 updateUI('disconnected');});async function safeRead(reader) { try { while (true) { const { value, done } = await reader.read(); if (done) break; handleData(value); } } catch (err) { // 设备突然断开时 read() 会抛错,这里兜住别让它冒泡崩掉页面 console.error('读取异常,可能是设备断开:', err.message); } finally { reader.releaseLock(); updateUI('idle'); }}
还有个更隐蔽的坑:设备重插之后,原来的那个SerialPort对象已经失效了,你千万别想着复用它。正确的做法是重新走一遍requestPort()拿新对象。不过每次重插都让用户手动点选设备也挺烦的,这里可以用getPorts()拿到之前授权过的端口列表,里面如果正好有目标设备,就能跳过选择框直接连。这个技巧做自动化重连的时候特别好用。
js// 自动重连:从已授权端口里找匹配的,跳过手动选择async function reconnect(previousPort) { const ports = await navigator.serial.getPorts(); // 已授权的端口列表 for (const p of ports) { const info = p.getInfo(); // { usbVendorId, usbProductId } // 用 VID / PID 比对,认出是不是原来那台设备 if (info.usbVendorId === 0x2341 && info.usbProductId === 0x0043) { await p.open({ baudRate: 115200 }); return p; } } // 没找到,回退到让用户手动选 return await navigator.serial.requestPort();}
getInfo() 返回的是设备的厂商 ID(VID)和产品 ID(PID),相当于设备的身份证。用它来认设备比让用户在一串"USB-Enhanced-SERIAL"这种没辨识度的名字里挑靠谱多了。说起来,设备选择的用户体验真是个容易被忽视的问题——操作工根本分不清那串 VID/PID 谁是谁,所以界面上最好给点清晰的引导,或者干脆用 VID/PID 主动过滤。
兼容性这块,别抱侥幸心理
技术再好,浏览器不支持一切白搭。Web Serial API 目前只有 Chromium 内核的桌面浏览器支持——Chrome、Edge、Opera 这些。Firefox 和 Safari 到今天都没跟进,移动浏览器基本也别想。所以如果你的用户里有人用 Safari,这条路直接走不通,得另想退路。
还有个硬性限制:它只能在安全上下文里用,也就是 HTTPS 或者 localhost。你拿 file:// 双击打开一个 HTML 文件去调,必失败。线上必须配好 HTTPS 证书,内网部署如果没有 HTTPS 也一样调不出来。这一点在需求评审阶段就得确认清楚,别等代码写完了才发现环境不支持。
我把常见方案拉个表,选型的时候心里有数:
| 方案 | 部署成本 | 浏览器兼容 | 是否需要安装 | 适用场景 |
|---|---|---|---|---|
| Web Serial API | 低,纯网页上线 | 仅 Chromium 内核 | 否 | 内部系统、浏览器可控的环境 |
| 本地代理 + WebSocket | 中,要装程序 | 所有现代浏览器 | 是 | 对外发布、管不了浏览器版本 |
| Electron 应用 | 高,要打包分发 | 内置 Chromium | 是 | 离线运行、要系统级能力 |
| Web Bluetooth | 低,纯网页 | Chrome / Edge 等 | 否 | 低功耗蓝牙设备 |
Web Serial 最大的优势就是部署成本低,改个页面就能上线,没有安装包和版本同步的烦恼。代价也很直白:浏览器限制死,安全上下文卡着。所以我的判断是——它特别适合浏览器环境可控的内部系统(工厂、实验室、运维后台),而不是那种什么用户都可能来的公开网站。
另外提醒一句,别指望 Web Serial API 能替代专业的串口调试工具。它确实能读写,但实时波形、微秒级的时序控制这类需求,浏览器里根本做不了。JavaScript 不是实时语言,Web Serial API 也不对延迟做任何保证。把时间敏感的逻辑压到前端,迟早出事。这跟之前写 PHP 8.4 Property Hooks 实战:用属性钩子告别样板 Getter/Setter(虚拟属性与接口约束) 时那个感受类似——不要指望某一个新的语言特性或 API 去扛它本来不负责的那部分职责,该分层就分层。
落地之前,先把这几件事想明白
如果你也准备在生产环境上 Web Serial API,我按踩坑的顺序给几条建议,能少走不少弯路。
第一,先把设备协议写成文档。帧格式、指令集、错误码,一条条列清楚。这是后面所有工作的基础。协议都没吃透就急着写代码,纯粹是给自己挖坑。
第二,用现成的串口调试工具把协议完整验证一遍,确认每一条指令的收发都符合预期,再动手写前端。别在协议还没确认的情况下就开始实现——我见过太多这种返工。
第三,把分帧、校验、超时、重试这些逻辑单独封成一个协议层,别让它们散落到各个 UI 组件里。这也是我一直坚持的做法。说得直白点,就是把脏活累活关进一个笼子,UI 层只管调干净的接口。你不封这一层,代码很快就会变成一团谁都不敢碰的乱麻——甚至会让你怀念起 CSS :has() 关系选择器实战:用"父级选子级"写出更聪明的组件样式(链式与 :not() 组合)那种"选择器一改、样式全跟着走"的清爽感,起码那边的逻辑是收敛的。
第四,先把异常路径写完——断线重连、设备插拔、超时重试——再去做功能界面。顺序反了很容易返工,因为异常逻辑往往会反过来要求你调整正常流程的设计。
还有个 Windows 特有的坑:串口是独占的。网页占了一个端口,其他程序就打不开它了。如果设备本身连接数有限,界面上最好体现出占用状态,免得用户反复点"连接"把事情搞乱。
写在最后
Web Serial API 不是个复杂的 API,概念清爽、代码也不多。它真正的价值在于,把串口通信的门槛从"必须装个软件"降到了"打开网页就能用"。对于大量跟硬件打交道的内部系统——设备管理后台、实验室数据采集、自助设备运维——这是个值得认真考虑的方向。
但别把 API 和工程量混为一谈。API 只是入口,真正吃时间的是协议解析、异常恢复和用户体验这三块。设备协议吃透了,异常路径写完整了,这套方案才能真正稳稳当当跑在生产环境里。反过来,要是只把 requestPort()调通就以为大功告成,那离上线还差着十万八千里。
我这篇写的东西,与其说是教程,不如说是一份踩坑清单。你要是也正准备在浏览器里跟硬件对话,希望这些坑你能绕过去,别像我一样一个个用头撞出来。
标签:Web Serial API, requestPort, 串口通信, 硬件交互, 数据流描述:从真实踩坑场景出发,讲透 Web Serial API 在浏览器里读写串口的完整流程:requestPort 授权、port.open 配置波特率、readable/writable 数据流收发,以及半包粘包、断线重连、超时熔断等工程难题,并对比本地代理与 Electron 方案,帮你判断它适不适合落地。



发表评论发布评论后审核成功,即可显示在列表中...