#PHPSwoole协程实战:把串行的IO等待变成并发(go/Channel/WaitGroup)我第一次用Swoole协程的时候,犯过一个特别蠢的错。当时我想并发抓三个接口的数据,于是一口气写了三个`curl_exec…
PHP Swoole 协程实战:把串行的 IO 等待变成并发(go/Channel/WaitGroup)
PHP Swoole 协程实战:把串行的 IO 等待变成并发(go/Channel/WaitGroup)
我第一次用 Swoole 协程的时候,犯过一个特别蠢的错。当时我想并发抓三个接口的数据,于是一口气写了三个 curl_exec(),结果跑起来比串行还慢,CPU 还飙到 100%。后来才反应过来:我那根本不是协程,只是把三个同步阻塞调用堆在一起,谁也不让谁,纯纯的"假并发"。
为了搞明白"协程到底怎么用",我前后折腾了快两周。看官方文档看不懂,看别人的 demo 又总觉得"看着能跑但不知道为什么能跑"。直到我把一个真实的串行脚本改造成协程版,亲眼看到耗时从 2.4 秒掉到 0.8 秒,才真正"通了"。这篇我就把我这两周踩过的坑、想通的道理,按能直接上手的方式讲给你,省得你再走我的弯路。
先说结论,Swoole 协程异步到底怎么用?核心就三点:
- 先开一个协程环境(容器);
- 用
go()把要做 IO 的任务丢进去并发跑; - 剩下的 IO 等待,Swoole 自动帮你非阻塞处理,不用你管回调。
别被"协程"俩字吓到,它比你想的简单,也比你想的容易翻车。下面一条条拆。
先把环境搞对:扩展装错全白搭
我见过太多人代码写得没问题,一跑就报Class 'Swoole\Coroutine' not found,折腾半天才发现扩展没开或者版本不对。地基不牢,后面全白搭。这几步建议你新机器上先验一遍:
- 确认扩展已加载:
php -m | grep swoole能看到 swoole 才行。看不到就去 php.ini 加extension=swoole,Windows 下是extension=php_swoole.dll,然后重启你的 PHP 服务。 - 版本别太老:协程相关 API 从 Swoole 2.x 就有,但
Co\run这种写法在 4.x 才稳定,建议直接上 4.8+。PHP 侧至少 PHP 7.2,现在都 2026 年了,PHP 8.x 完全没问题,JIT 还能再帮你榨点性能。 - 不要和 pthreads 或其他协程库混用:Swoole 的协程是独占事件循环的,你再塞个别的协程方案进来,调度直接打架,表现就是偶发卡死、诡异崩溃。
php --ri swoole看一眼编译选项:确认coroutine是 enabled。有些精简编译把这块关了,代码写得再对也跑不起来,报错还特别迷惑。
这块属于"不起眼但能卡你一下午"的坑。我现在的习惯是每台新机器部署前必跑php --ri swoole,十秒钟省下后面几小时。
协程环境到底怎么开
这是最容易迷糊的地方。Swoole 不会因为你装了扩展就自动把所有代码变协程,你得先"开个场子"。开场子有两种主流姿势,按你的场景选。
第一种:Co\run()临时开一个。适合命令行脚本、定时任务、一次性并发抓取这种"跑完就退"的场景。它接受一个闭包,闭包里你就能随便go()了:
php<?php// 用 Co\run() 临时开一个协程容器,脚本跑完就自动退出Co\run(function () { // go() 启动一个子协程,里面可以放心做 IO 等待 go(function () { echo"任务A 开始\n"; Co::sleep(1); // 注意:是 Co::sleep 不是 sleep!否则卡死整个进程 echo"任务A 结束\n"; }); // 再起一个,和上面的任务A"同时"等待,而不是排队 go(function () { echo"任务B 开始\n"; Co::sleep(0.5); echo"任务B 结束\n"; });});
上面这段代码,任务A 睡 1 秒、任务B 睡 0.5 秒。如果你用普通 sleep() 串行写,总耗时是 1.5 秒;但用 Co\run+go(),A 和 B 是同时发起的,总耗时约等于最慢那个,也就是 1 秒。这就是协程最直观的好处——把串行的等待时间,压成了"取最大值"而不是"求和"。
第二种:Swoole\Runtime::enableCoroutine()全局开。 适合常驻的 HTTP 服务,比如用 Swoole 自带的 Server。在 start() 之前调一次,之后一堆原本阻塞的 IO 操作(file_get_contents、PDO、curl、Redis、MySQL)会被 Swoole 自动"协程化",你写起来还是同步那套写法,但底层已经是非阻塞了:
php<?php// 全局开启"一键协程化",一行顶一堆事Swoole\Runtime::enableCoroutine();$server = new Swoole\Http\Server('0.0.0.0', 9501);$server->on('request', function ($request, $response) { // 下面这些原本会阻塞的调用,开启 Runtime 后自动变非阻塞 $pdo = new PDO('mysql:host=127.0.0.1;dbname=test', 'user', 'pass'); $stmt = $pdo->query('SELECT * FROM users WHERE id = 1'); $user = $stmt->fetch(PDO::FETCH_ASSOC); // 看起来同步,实际不卡进程 $redis = new Redis(); $redis->connect('127.0.0.1', 6379); $cache = $redis->get('user:1'); // 同样非阻塞 $response->end(json_encode([$user, $cache]));});$server->start();
我自己更常用Co\run()写工具脚本,因为心智负担小;但线上服务基本都走Runtime::enableCoroutine()全局开,毕竟不可能给每个请求都Co\run()一层。
为什么协程比串行快?把账算给你看
这个问题不搞明白,你永远是"知其然不知其所以然",出了性能问题也没法排查。
假设你有三个外部接口要调,每个平均耗时 800ms:
- 串行写法:调完 A 等 800ms,再调 B 等 800ms,再调 C 等 800ms,总共 2400ms。注意这 2400ms 里,CPU 大部分时间在"等网络回来",干等着,啥正事没干。
- 协程写法:三个请求同时
go()发出去,各自的 IO 等待期间,CPU 切去处理别的协程。等三个响应都回来,总耗时约等于最慢那个,也就是 ~800ms。
快了 3 倍,而且请求越多倍数越夸张。本质上,协程是在一个线程内做用户态调度:当一个协程遇到 IO(网络、磁盘、sleep),它就主动让出 CPU,让同容器的其他协程继续跑;等 IO 好了再被唤醒。整个过程没有线程切换的内核开销,所以比多线程轻得多,单机轻轻松松跑几万协程。
不过我得泼盆冷水:协程只在"IO 密集"场景爽,CPU 密集的计算(比如大循环、加密解密)它救不了你,因为计算时不会主动让出。那种场景老老实实上 Swoole 的 Process或者多进程。
为了让你更直观地感受差距,下面把"串行"和"协程"两种写法摆一起对比一下性能:
php<?php// 串行写法:三个请求排队,耗时 = 800 + 800 + 800 ≈ 2400ms$t1 = microtime(true);file_get_contents('http://www.baidu.com'); // 阻塞 800msfile_get_contents('http://api.github.com'); // 再阻塞 800msfile_get_contents('http://httpbin.org'); // 再阻塞 800msecho"串行耗时:" . round(microtime(true) - $t1, 3) ."s\n";// 协程写法:三个请求同时发出,耗时 ≈ 最慢那个 ≈ 800ms$t2 = microtime(true);Co\run(function () { $hosts = ['www.baidu.com', 'api.github.com', 'httpbin.org']; foreach ($hosts as $host) { go(function () use ($host) { $client = new Swoole\Coroutine\Http\Client($host, 443, true); $client->get('/'); // 网络等待期间自动让出 CPU $client->close(); }); }});echo"协程耗时:" . round(microtime(true) - $t2, 3) ."s\n";
注意这 2.4 秒里,CPU 大部分时间在"等网络回来",啥正事没干。而协程版把这三段等待重叠在一起,等于你烧水的同时去切菜、择菜,水开了菜也切好了——这就是"并发"和"并行"的区别:协程是单线程内的并发(交替前进),不是多核并行。
协程、多线程、多进程,到底该选谁
很多人一听"并发"就想到开进程开线程,其实这三兄弟解决的问题不一样,别乱用:
- 多进程:最稳,一个崩了不影响别的,但内存开销大(每个进程一份 PHP 解释器),进程间通信也麻烦。
- 多线程:共享内存、切换便宜,但 PHP 的多线程基本靠 pthreads 扩展,而且线程安全(ZTS)编出来的 PHP 性能掉一截,生产里很少用。
- 协程:单进程单线程内做用户态调度,内存占用极低(一个协程就几 KB 栈),切换几乎零成本,缺点是单核、怕 CPU 密集。
所以 Swoole 的经典组合是"多进程 + 每进程内多协程":用 Swoole\Http\Server 起多个 worker 进程扛并发,每个 worker 内部再用协程扛 IO。这样既有进程级的隔离稳,又有协程级的轻量快。我自己的线上服务基本都是这个架构,扛过日活几十万的接口,从来没出过协程相关的幺蛾子。
go() 并发请求实战:Swoole\Coroutine\Http\Client
并发抓数据最常用Swoole\Coroutine\Http\Client,它是协程版的 HTTP 客户端,底层自动非阻塞,写法和同步客户端几乎一样:
php<?phpuse Swoole\Coroutine\Http\Client;Co\run(function () { $hosts = [ '百度' => 'www.baidu.com', 'GitHub' => 'api.github.com', ]; foreach ($hosts as $name => $host) { // 每个 host 起一个协程并发请求 go(function () use ($name, $host) { // 第三个参数 true 表示走 SSL(https) $client = new Client($host, 443, true); $client->setHeaders(['Host' => $host, 'User-Agent' => 'swoole']); $client->get('/'); // 发请求,遇到网络等待自动让出 CPU echo"{$name} 返回" . strlen($client->body) ." 字节\n"; $client->close(); }); } // 这里要注意:主协程如果不等,脚本会直接退出});
跑这段代码你会看到,百度那条和 GitHub 那条几乎是"同时"打出来的,而不是先等完百度再等 GitHub。这就是并发的实感。
这里有个坑我必须提醒:Swoole\Coroutine\Http\Client 的构造函数第二个参数是端口,第三个才是是否 SSL。新手经常把 api.github.com 直接丢进去又忘了 443 和 true,结果连不上还不知道为啥。另外 setHeaders里最好带上Host和User-Agent,有些站点没 UA 直接返 403,调试时能让你少抓半小时头发。
如果你想把协程并发这套思路和"浏览器里点对点通信"对照着理解,可以看WebRTC DataChannel 实战:不依赖服务器的点对点消息传输(ICE/STUN 与信令),那里是前端侧的异步通道,概念上有点像跨端版的 Channel。
Channel:协程之间怎么传数据
go()把任务并发出去了,但子协程的结果怎么收回来?用全局数组?错,协程里共享全局变量是个大坑(后面讲坑的时候细说)。正解是Swoole\Coroutine\Channel,它是协程安全的队列,生产者和消费者通过它传递数据,没有数据时会自动挂起等待:
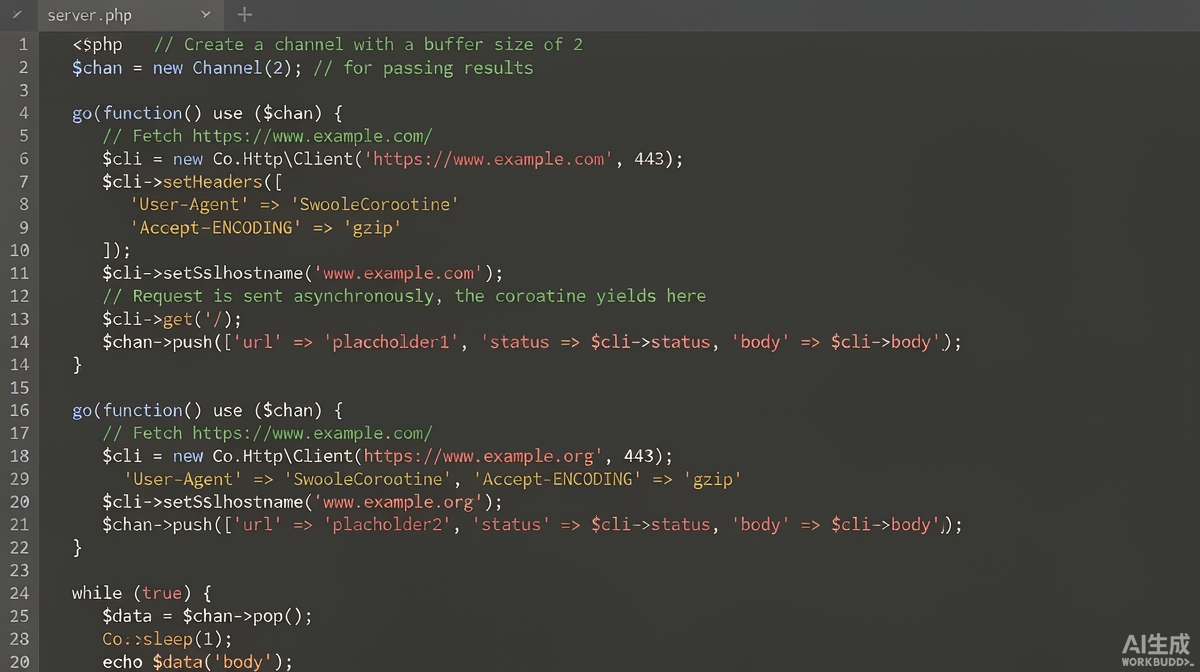
php<?phpCo\run(function () { // 缓冲区大小为 2,超过会背压(push 时挂起等消费) $channel = new Swoole\Coroutine\Channel(2); // 生产者1:抓百度,结果塞进 channel go(function () use ($channel) { $client = new Swoole\Coroutine\Http\Client('www.baidu.com', 443, true); $client->get('/'); $channel->push(['baidu' => strlen($client->body)]); // 塞数据,满了就等 $client->close(); }); // 生产者2:做个计时,结果也塞进 channel go(function () use ($channel) { Co::sleep(0.3); $channel->push(['timer' => '0.3s done']); }); // 消费者:主协程取两次,没数据会自动挂起等生产者 for ($i = 0; $i < 2; $i++) { $data = $channel->pop(); var_dump($data); }});
Channel 的价值在于它把"并发生产者 + 串行消费者"这个模式写得特别干净。你不用自己写锁、不用自己轮询,挂起唤醒全交给 Swoole。缓冲区大小这块我一般设成并发任务数,或者干脆不设(无缓冲,纯同步交接),看你要不要削峰。
Channel 还有两个我自己常用的技巧,顺手说一下:
pop()带超时:$channel->pop(1.0)表示最多等 1 秒,超时返回 false。这能避免生产者挂了、消费者永远傻等的死局。我一般生产环境都加超时,宁可丢一条数据也别把主协程吊死。Channel::select()多路监听:能同时盯着多个 channel,谁先有数据先处理谁,类似 IO 多路复用。我拿它做"竞速"——比如同一个数据从 Redis 和 MySQL 各取一份,哪个先回来用哪个,慢的那个直接丢弃,接口延迟直接砍半。
另外 Symfony 那一票 PHP 8 新特性里,注解驱动的路由其实和 Channel 这套"解耦"思想是相通的——把"做什么"和"什么时候做"分开。感兴趣可以移步 [[PHP 8 Attributes 注解实战:用 #[Route] 取代注释解析(反射读取与路由映射)]],看看属性怎么把配置从字符串注释里解放出来。
WaitGroup:等所有任务都干完再收工
如果场景是"并发发 N 个请求,全部回来后统一汇总",WaitGroup 比手动数 Channel 更直观。它就像军训点名:起一个任务 +1,干完-1,主协程wait()等到归零:
php<?phpuse Swoole\Coroutine\WaitGroup;Co\run(function () { $wg = new WaitGroup(); $results = []; $tasks = [ '百度' => 'www.baidu.com', 'GitHub' => 'api.github.com', '示例' => 'httpbin.org', ]; foreach ($tasks as $name => $host) { $wg->add(); // 每起一个并发任务,计数器 +1 go(function () use ($name, $host, $wg, &$results) { $client = new Swoole\Coroutine\Http\Client($host, 443, true); $client->get('/'); $results[$name] = strlen($client->body); // 各自写各自的 key,互不冲突 $client->close(); $wg->done(); // 任务结束,计数器 -1 }); } $wg->wait(); // 主协程阻塞在这,等所有 done() 把计数减到 0 var_dump($results); // 三个结果都齐了才往下走});
WaitGroup的关键点是:$wg->add()必须在go()之前或之内调用,且done()一定要调,漏一个done()主协程就永远卡在wait()。我以前就因为在一个分支里忘了done(),脚本跑完不退出,还以为是 Swoole 的 bug,查了半天才发现是自己漏写。建议把 done()放进try/finally,保证异常了也能减计数。
其实这种"多任务并发、等全部完成再汇总"的模式,在浏览器多标签页之间也能玩——比如登录态要在多个 tab 同步,可以看 BroadcastChannel 实战:同源多标签页实时通信(登录态同步与状态广播),那是前端的广播通道,思路和 WaitGroup 的"等大家到齐"异曲同工。
数据库和 Redis 连接的正确姿势
协程环境里连数据库,必须用 Swoole 自带的协程客户端,不能用同步版。具体:
- MySQL:用
Swoole\Coroutine\MySQL,connect之后直接query(),没有回调,写法跟同步一样; - Redis:用
Swoole\Coroutine\Redis,set/get都是同步写法,底层非阻塞; - 连接复用:每个协程尽量用独立连接,或者用连接池。Swoole 5.0+ 支持
Swoole\Coroutine\MySQL\Pool; - 千万别共用实例:多个协程共用同一个 MySQL 对象,状态会乱套(连接状态、事务、查询结果互相踩),这是新手第二常见的翻车点。
说白了,协程客户端的"同步写法"是 Swoole 给你的最大温柔——你几乎不用改业务代码风格,只换类名,性能就上去了。但温柔背后有代价:底层那根连接是被调度器接管的,你不能在协程外随便用。
如果你要往数据库里落地一些离线缓存、本地索引之类的数据,前端侧有个更轻量的方案,可以对照着看IndexedDB 前端数据库实战:离线应用与索引查询(增删改查与事务),那是浏览器里的本地库,和 Swoole 的协程 MySQL 在不同层解决"数据存取"问题。
常见坑:这些地方最容易翻车
协程不是魔法,下面这几个坑我基本都踩过,列出来给你排雷:
坑 1:同步函数卡死整个事件循环。sleep()、file_get_contents()(没开 Runtime 时)、exec()这些是会阻塞整个进程的,一旦在协程里调用,所有其他协程全被冻住。正确替换:
sleep(1)→Co::sleep(1)file_get_contents($f)→Swoole\Coroutine\FileSystem::readFile($f)exec($cmd)→Co::exec($cmd)
坑 2:全局变量不安全。 协程之间看到的是同一份全局/静态变量,但执行时序是交错的。你在 A 协程改了 static $x,B 协程读到的可能已经是被改过的。正确做法是用 Co::getContext()存每个协程独立的数据,或者通过函数参数、Channel传值。
坑 3:异常不冒泡。协程内的throw不会跑到外层go()外面去,你必须在每个go()块里自己try/catch,否则异常直接被吞,你连错在哪都不知道。
坑 4:调试要打协程 ID。多个协程的日志会混在一起,分不清谁是谁。用Co::getCid() 拿当前协程 ID,打进日志,排查时能救命。
再加两个我常提醒同事的点,都是血泪教训:
$_GET/$_POST/$_SERVER在常驻服务里不可信:这些超全局变量是请求级的,协程切换时可能被别的请求覆盖。正确做法是从$request对象取,或者用协程上下文存。曾经我图省事直接读$_GET,结果偶发拿到隔壁请求的参数,查了两天。- 别在
array_walk/array_map的闭包里做 IO:这些函数不是协程感知的,闭包里的 IO 不会让出,等于白并发。要并发就老老实实go()+WaitGroup,别想着走捷径。
下面这段代码把坑 2、坑 3、坑 4 一起演示了:
php<?phpCo\run(function () { // 错误示范:多个协程共享改同一个全局计数,结果不可预期 $counter = 0; for ($i = 0; $i < 3; $i++) { go(function () use (&$counter) { Co::sleep(0.1); $counter++; // 并发自增,没有隔离,最终值不一定等于 3 }); } // 正确示范:协程上下文 + 异常捕获 + 打 CID go(function () { $cid = Co::getCid(); // 拿协程 ID,日志必备 $ctx = Co::getContext(); // 每个协程独立的数据袋 $ctx['trace_id'] = uniqid(); // 存自己的数据,不污染别人 try { // 协程内异常不会冒泡,必须自己 catch if (random_int(0, 1) === 0) { throw new RuntimeException('模拟一个 IO 错误'); } } catch (Throwable $e) { echo"[cid={$cid}] 出错: {$e->getMessage()}\n"; } });});
写到这我突然想到,如果你玩 PHP 已经玩到协程这一层,那顺手把"直接调 C 函数"也学了其实收益很大——比如要搞点高性能计算,可以看 PHP FFI 实战:在 PHP 里直接调用 C 函数(libc/自定义 so 与内存对齐),FFI 让你绕过扩展直接调 libc,和协程配合能做不少黑科技。
来一个完整的:并发抓取并汇总成报告
光讲散点不够过瘾,我给你串一个能直接跑的完整脚本:开协程容器,并发抓三个站点,用 Channel 收结果,最后统计总字节数。把前面学的全用上:
php<?phpuse Swoole\Coroutine\Http\Client;use Swoole\Coroutine\Channel;Co\run(function () { $channel = new Channel(10); // 缓冲 10,足够装下所有结果 $hosts = ['www.baidu.com', 'api.github.com', 'httpbin.org']; $start = microtime(true); foreach ($hosts as $host) { go(function () use ($host, $channel) { $client = new Client($host, 443, true); $client->setHeaders(['Host' => $host]); $client->get('/'); $len = strlen($client->body); $channel->push("{$host} => {$len} 字节"); // 丢结果进 channel $client->close(); }); } // 主协程取齐所有结果(数量 = host 数) for ($i = 0; $i < count($hosts); $i++) { echo $channel->pop() ."\n"; } echo"全部完成,总耗时:" . round(microtime(true) - $start, 3) ."s\n";});
这个脚本单次跑可能看不出太大优势,但当你抓的站点从 3 个变成 300 个时,串行要几分钟,协程版还是那一两秒——这就是协程在真实爬虫、批量通知、聚合接口里的威力。我自己的一个"聚合几十个第三方 API"的接口,从串行 12 秒优化到协程版 1.3 秒,老板以为我重构了整个架构,其实就加了 Co\run+go()。这种"改动小、收益大"的优化,才是协程最迷人的地方。
我的一点使用心得
协程这套东西,入门快、精通难。但先泼一盆清醒水:协程不是银弹,有些场景它真的帮不上忙,硬上反而添乱。我总结了几条"别上协程"的判断:
- 你的瓶颈是 CPU 密集计算(视频转码、大批量加密、复杂算法),协程不会让计算变快,老老实实上多进程或多机分片;
- 你的请求量本来就极小(一天几百次),串行写法清清楚楚,强行协程只会增加维护成本;
- 你依赖一堆不支持协程化的同步扩展(比如某些老旧的数据库驱动),又不想改客户端,那协程化会处处踩雷。
把这几条排除掉,剩下的 IO 密集、高并发、要等外部接口的场景,才是协程的主场。别为了"用新技术"而用新技术,这是我踩了无数坑之后最实在的体会。
我自己的经验是:
- 小脚本用
Co\run(),服务用Runtime::enableCoroutine(),别混着来; - 并发结果传递,无结构化用
WaitGroup汇总,要流式交互用Channel; - 所有 IO 客户端全换协程版,一个同步调用就能拖垮整池;
- 日志必带
getCid(),否则出事你连哪条协程崩的都看不出; done()进finally,WaitGroup 漏一个就卡死。
还有个实操建议:上线前用Co::stats()或Swoole\Coroutine::stats()看一眼当前协程数,如果数字一直涨不下来,八成是哪个协程没正常退出(典型就是漏了done() 或 Channel 没 pop 完)。我每次压测都会盯这个指标,比看 CPU 还准。
Swoole 协程真正的价值,不是让你代码写得多炫,而是把"等待"这件最浪费时间的事,变得几乎不花钱。你原来串行要 2.4 秒的三次请求,协程一包变成 0.8 秒,代码量没多几行,性能直接翻三倍——这种投入产出比,在 PHP 世界里真的少见。
最后啰嗦一句版本:上面这些 API 在 Swoole 4.x 就稳定了,Co\run是Swoole\Coroutine\run的别名,老文档里可能还看到go()要写成Swoole\Coroutine::create(),现在直接go() 就行,别被老教程带偏。另外如果你用的是 Swoole 6.x,短名 go()和Co默认开启,省心;但有些发行版编译时关了短名,那种情况老老实实写全名Swoole\Coroutine\run()和Swoole\Coroutine::create(),别硬刚。
标签:Swoole, 协程, Coroutine, Channel, PHP异步描述:从协程环境开启(Co\run / Runtime::enableCoroutine)、go() 并发请求、Channel 数据传递到 WaitGroup 汇总,手把手讲清 Swoole 协程怎么把串行 IO 等待变成并发,并附可直接复制运行的 PHP 代码与常见配置坑,帮你把多次网络请求从"求和耗时"压成"取最慢值"。



发表评论发布评论后审核成功,即可显示在列表中...