#WebWorkers实战:把计算密集型任务丢给后台线程(SharedWorker与多线程通信)我第一次被"假死"教做人,是在做一个后台数据看板的时候。当时的需求很朴素:前端拉取十万行订单数据,用户在搜索框里打字,要实时过滤、排…
Web Workers 实战:把计算密集型任务丢给后台线程(SharedWorker 与多线程通信)
Web Workers 实战:把计算密集型任务丢给后台线程(SharedWorker 与多线程通信)
我第一次被"假死"教做人,是在做一个后台数据看板的时候。当时的需求很朴素:前端拉取十万行订单数据,用户在搜索框里打字,要实时过滤、排序、统计。我信心满满地写了个 for 循环加 Array.filter,本地两千条数据跑得飞起。结果一上真实数据,用户在输入框敲一个字,页面像被点了穴一样卡死三秒,连鼠标都拖不动,控制台里连个报错都没有——就是单纯地"没反应"。我当时的第一反应特别蠢:是不是我代码写得不够快?于是我把算法从冒泡换成了快排,又上了二分查找,折腾一礼拜,卡顿从三秒降到两秒。直到同事丢给我一句"你是想用单线程硬刚 CPU 密集型任务?",我才意识到自己掉进了一个最基础也最容易被忽略的认知误区里:JavaScript 是单线程的,主线程既负责算数,又负责渲染、又负责响应用户点击,你让它在那吭哧吭哧跑十万次循环,它拿什么空去画页面?
当年我还干过更离谱的事:听说 setTimeout 能把任务"异步"掉,就天真地把重计算包了一层 setTimeout(fn, 0),以为这样就不卡了。后来才懂,setTimeout 只是把任务挪到了事件队列末尾,它照样跑在主线程上,该卡还是卡,只不过是"晚一点再卡"。真正能把计算"搬"出主线程、让 UI 始终保持丝滑的手段,是浏览器原生提供的 Web Workers——这也是我后面要反复讲的东西。
一、先说结论:JS 单线程 ≠ 不能多线程,核心就三种 Worker
先把最容易混淆的概念掰清楚。很多人一听到"多线程"就觉得 JS 做不到,那是把"语言单线程"和"运行环境单线程"搞混了。JS 引擎确实是单线程执行脚本的,但现代浏览器给它配了一整套"后台线程"机制。先记牢一个核心认知:Web Workers 不是让 JS 变成多线程语言,而是在主线程之外开辟独立的、内存隔离的线程来跑脚本,主线程和 Worker 各干各的,互不打扰。
浏览器里能用的 Worker 主要有三类,别再张冠李戴:
- Dedicated Worker(专用 Worker):一对一,谁创建谁独占,最适合把一个页面里的重计算拆出去。
- SharedWorker(共享 Worker):同源下多个页面、iframe 甚至其他 SharedWorker 能连同一个实例,跨标签页共享状态就靠它。
- Service Worker:拦截网络请求、做离线缓存,主要服务 PWA,跟"计算卸载"关系不大,本文不展开。
补充一个底层认知,能帮你彻底摆脱"假死"噩梦:浏览器强制 GUI 渲染线程和 JS 主线程互斥——JS 在执行的时候,渲染就被挂起;渲染进行的时候,JS 被暂停。所以你那个十万次循环一跑,主线程被占满,浏览器连一帧都画不出来,用户看到的就是"卡死"。Web Workers 的巧妙之处在于,它运行在完全独立的线程上下文,既不参与这套互斥,也不会触发 reflow / repaint,于是哪怕 Worker 在后台排一百万条数据,主线程该滚动滚动、该响应点击响应点击,两不相干。
为什么我强调先分清楚?因为后来我在项目里踩过坑:本来只需要单页面后台算个东西,我图省事用了 SharedWorker,结果 Safari 直接不支持,线上一堆 iOS 用户反馈功能失效——这就是没搞清"该用哪种 Worker"付出的代价。关于浏览器支持情况,caniuse 上写得明明白白:SharedWorker 兼容性,Safari 和 iOS 全家桶至今没跟上,这一点后面会专门讲。
二、Dedicated Worker 实战:把计算丢进后台线程
先上最常用、也最好理解的专用 Worker。核心思路一句话:主线程负责 UI 和交互,把那个会让页面卡死的耗时函数,整个搬进 worker.js,算完了用 postMessage 把结果丢回来。
javascript// ===== main.js(主线程)=====// 创建一个专用 Worker,脚本必须是独立文件、且与页面同源const worker = new Worker('./compute-worker.js');// 主线程向 Worker 发送待处理的数据worker.postMessage({ type: 'compute', payload: bigArray });// 监听 Worker 算完回传的结果worker.onmessage = (e) => { console.log('Worker 算完了,结果是:', e.data);};// ===== compute-worker.js(Worker 线程)=====// Worker 内部全局对象是 self,没有 window / document / localStorageself.onmessage = (e) => { const { type, payload } = e.data; // 这里跑你的耗时计算:排序、过滤、海量数据聚合都行 const result = heavyComputation(payload); // 把结果丢回主线程 self.postMessage(result);};
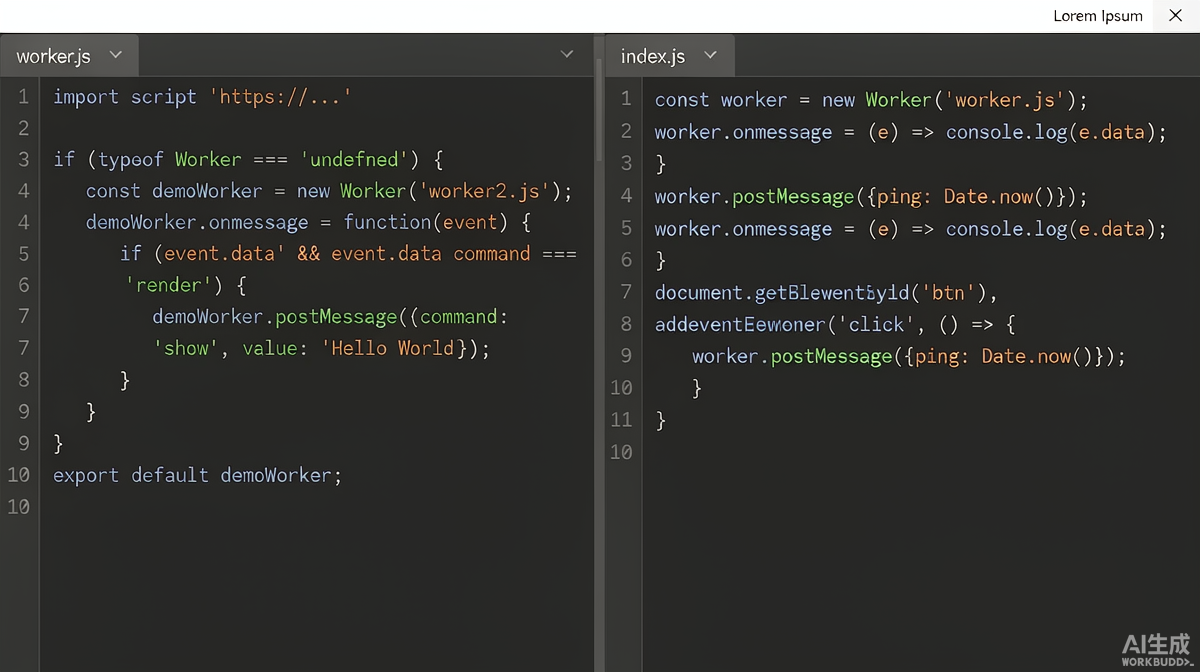
上面这段代码就是最朴素的多线程通信骨架。我第一次跑通的时候,看着页面在算十万条数据的同时还能流畅地拖动滚动条,那种"原来前端也能这么爽"的感觉,至今记得。但它背后有几个必须讲透的点,否则你很快就会栽跟头。
第一,Worker 脚本必须是个独立文件,不能像普通函数那样内联写;它也不能访问 DOM,你在里面写 document.getElementById 会直接报错。第二,主线程和 Worker 之间靠 postMessage 发、onmessage 收,这是唯一的通道。第三,很多人以为 Worker 能直接"看到"主线程的变量,其实不能——两边内存是隔离的,传过去的是数据的副本。这点就是下一节要讲的、最容易出性能问题的"坑"。
多说一句"self"这件事。Worker 里的全局对象不是 window,而是 self(你也可以直接写 onmessage,它等同于 self.onmessage)。这意味着你在 Worker 里能用的 API 是"阉割版"的:可以用 fetch、setTimeout、WebAssembly、IndexedDB,但 window、document、parent 这些和页面强绑定的东西一概没有。我刚上手时曾在 Worker 里顺手写了一句 location.href 想做跳转,结果直接抛错——页面跳转这种事本来就不属于后台线程的活儿。理解了这个边界,你就不会再尝试把"改 DOM"的逻辑塞进 Worker,而是老老实实让主线程当"渲染代理"。
如果你想在 Worker 里做后台网络请求、流式拉取大文件,可以参考 Fetch + AbortController + Streams 实战:现代请求的中断与流式读取(进度/取消),把请求和解析都塞进线程里,主线程只负责渲染进度条,体验会好非常多。
三、真正容易踩的坑:数据传递是"拷贝",不是"共享"
刚用 Worker 的人几乎都会栽在同一个地方:传一份几百 MB 的数组进去,页面反而更卡了。原因我在源码注释里也埋了伏笔——主线程和 Worker 之间默认走的是结构化克隆(Structured Clone),也就是说,你 postMessage 出去的数据,浏览器会在发送端序列化、接收端反序列化,等于整份数据被深拷贝了一份。数据小还好,数据一大,光拷贝就够你喝一壶的。
那怎么优化?答案是Transferable Objects(可转移对象)。像 ArrayBuffer、MessagePort、ImageBitmap 这类,可以通过"所有权转移"的方式传过去——转移之后,发送方手里那份直接失效(长度变 0),接收方拿到完整内存,整个过程零拷贝,性能天差地别。
javascript// 主线程:准备一块 64MB 的二进制缓冲区const buffer = new ArrayBuffer(1024 * 1024 * 64);const view = new Float64Array(buffer);// 关键:postMessage 的第二个参数传 [buffer],表示把 buffer 的所有权转移给 Worker// 转移后主线程的 buffer 自动失效(变为 length 0),全程零拷贝worker.postMessage({ view }, [buffer]);// ===== Worker 端 =====self.onmessage = (e) => { const { view } = e.data; // 接到的就是那块真实内存,无需再拷贝 // ... 在里面做像素处理 / 数值计算 ... self.postMessage(result, [resultBuffer]); // 结果再转移回主线程};
这里我必须吐槽一句:Transferable 这种"转过去就没了"的语义,第一次用非常反直觉。我当年就因为没注意所有权转移,主线程转完 buffer 后又去读它,拿到一个空数组,debug 了半天才反应过来"东西已经被我寄走了"。所以记住:Transferable 是"搬家"不是"复印"。
顺便给你一个直观的数字概念:结构化克隆的成本和"数据体积"强相关,而且比单次大消息更坑的是"大量小消息"——频繁序列化开销会叠加。我曾传一个 10MB 的普通数组给 Worker,仅仅克隆这一步就花了上百毫秒,相当于把"优化卡顿"变成了"制造卡顿"。改用 Transferable 之后,同样是 10MB,postMessage 几乎瞬间返回,因为根本没发生拷贝。所以判断要不要上 Transferable 很简单:只要你想传的是 ArrayBuffer / TypedArray / ImageBitmap 这类大块二进制,闭眼用转移;如果是普通 JSON 对象且体积不大,克隆也就忍了。
另外,上 Worker 之前最好先量化一下收益。不是所有任务都该丢进后台,创建 Worker 本身有开销,任务太短反而得不偿失。建议先用 Performance API 实战:用 Navigation/Resource Timing 做前端性能监控(Web Vitals) 量一下主线程被某个计算占用了多少毫秒,确认超过几十毫秒、确实影响交互了,再动手上 Worker,这才是工程上负责任的态度。
四、SharedWorker 实战:让多个标签页共用一个线程
Dedicated Worker 解决的是"单页面内部"的计算卸载。但真实业务里还有一类需求它搞不定:比如你开了两个浏览器标签页登录同一个后台,希望它们共享一份实时状态——未读消息数、WebSocket 连接、缓存同步。如果用 Dedicated Worker,每个标签页各起一份,互相隔离,完全没法互通。这时候就得上 SharedWorker:同源下多个页面连的是同一个 Worker 实例,这才是跨标签页共享状态的唯一原生方案。
javascript// ===== main.js(页面中,tab A / tab B 都能跑这段代码)=====const worker = new SharedWorker('./shared-worker.js');// 必须显式调用 start(),否则消息发不出去,而且还不报错(最坑的一点,没有之一)worker.port.start();worker.port.postMessage({ type: 'init', data: 'hello from tab' });worker.port.onmessage = (e) => { console.log('来自 SharedWorker 的消息:', e.data);};// ===== shared-worker.js(共享线程脚本)=====// 注意:SharedWorker 没有 self.onmessage,它用的是 self.onconnectself.onconnect = (e) => { const port = e.ports[0]; // 拿到本次连接的端口 port.start(); port.onmessage = (msg) => { console.log('收到页面消息:', msg.data); port.postMessage({ ack: true, from: 'shared-worker' }); };};
写这段的时候我得再强调一次那个让我凌晨两点还在查文档的坑:SharedWorker 的通信全走 port 对象,不是直接 postMessage 到 worker。你 new SharedWorker() 之后线程并不会自动启动,必须 port.start() 把通道打开;而且 worker 脚本里监听的是 onconnect 而不是 onmessage——我无数次在 onconnect 外面写了 self.onmessage,然后对着永远不触发的回调怀疑人生。这些细节,MDN 的 SharedWorker 文档讲得很细,建议配合食用。
再讲一个 SharedWorker 最香的真实场景:多标签共享一条 WebSocket 长连接。假设你开了同一个后台的两个标签页,每个都用 Dedicated Worker 各自连一条 WebSocket,服务器得多维持一倍连接,带宽和心跳都翻倍。换成 SharedWorker,所有标签页共用一条后台连接,消息进来后由它统一分发给各个页面——既省资源又保证各页状态一致。这也是为什么我说"跨标签页共享状态,SharedWorker 是唯一原生方案":LocalStorage 的 storage 事件能同步一点字符串,但承载不了这种"统一连接 + 实时广播"的重活。
五、多端口管理:广播与共享状态
SharedWorker 最妙的用法,是把它当成一个"多标签页的中转服务器"。每个连进来的页面都会触发一次 onconnect,并拿到一个独立的 port。只要我们把这些 port 收集起来,就能实现"一个页面发消息、其他所有页面同步收到"的广播效果——实时计数器、协同编辑光标、多标签页登录态同步,本质都是这套机制。
javascript// shared-worker.jsconst ports = []; // 保存所有连进来的端口self.onconnect = (e) => { const port = e.ports[0]; ports.push(port); // 把新连接存起来 port.start(); port.onmessage = (msg) => { // 广播:把消息发给除自己以外的所有页面 ports.forEach((p) => { if (p !== port) p.postMessage(msg.data); }); };};
这里有个真实工程感受:当年我们用 SharedWorker 做多标签页的未读消息广播,本地开两个窗口测试一切正常,兴冲冲上了线,结果用户反馈"偶尔收不到同步"。排查一整天才发现,是某个标签页在 port.onmessage 里抛了异常、导致整条连接断掉,而我们没有做端口清理——ports 数组里还留着已失效的引用,广播时往死连接上 postMessage 直接静默失败。所以在 onconnect 里一定要监听 port.onclose 并把它从数组里剔除,这是血泪教训。
举一个我见过的典型落地:一个内部行情看板,交易员习惯开四五个标签页盯不同品种。我们把"最新报价"放在 SharedWorker 里维护,任意一个标签页收到行情推送后广播给其余页面,于是四五个标签页永远显示同一份数字,不会出现"A 页涨了 B 页还没动"的尴尬。这个功能如果纯靠前端轮询接口,接口压力和数据延迟都扛不住,而 SharedWorker 一次推送、多方同步,恰好扬长避短。
顺带一句,很多"多标签页状态同步"的场景,其实不一定非得上 Worker。如果你只是想在元素尺寸变化、DOM 变动时做响应,与其自己写轮询,不如看看 ResizeObserver 与 MutationObserver 实战:监听元素尺寸与 DOM 变化(告别轮询),浏览器原生 Observer 比手搓定时轮询优雅一百倍。
六、共享内存进阶:SharedArrayBuffer + Atomics
前面讲的 postMessage 都是"拷贝"或"转移",两边数据始终各一份。如果你的场景是多个 Worker 要同时读写同一块数据(比如图像像素处理、游戏物理模拟分块计算),反复拷来拷去就太浪费了。这时候可以用SharedArrayBuffer:它创建一块能被多个线程真正共享的内存,配合Atomics对象做原子操作,避免多线程竞态。
javascript// 主线程:创建一块 1024 字节的共享内存const sharedBuffer = new SharedArrayBuffer(1024);const sharedArray = new Int32Array(sharedBuffer);// 把共享内存交给 Worker(注意:这里是"共享",不是拷贝)worker.postMessage(sharedBuffer);// 多个线程可同时读写,必须用 Atomics 保证操作安全Atomics.add(sharedArray, 0, 1); // 索引 0 处原子加 1Atomics.load(sharedArray, 0); // 安全读取Atomics.store(sharedArray, 0, 42); // 安全写入
必须泼盆冷水:SharedArrayBuffer 不是随手就能用的"黑科技"。它需要页面开启 跨域隔离(Cross-Origin Isolation),也就是响应头里得带上 Cross-Origin-Opener-Policy: same-origin 和 Cross-Origin-Embedder-Policy: require-corp,否则浏览器直接禁用。而且一旦用了共享内存,没有 Atomics 保护就会出竞态 Bug,那种 Bug 时灵时不灵、复现都复现不出来,debug 难度指数级上升。所以我的建议是:能用 Transferable 解决就别碰共享内存,除非你真的在做高性能计算。
如果你真要用共享内存做线程同步,Atomics 还提供 wait / notify 机制,类似其他语言里的条件变量:一个线程在 Atomics.wait 上挂起等待,另一个线程改完值后 Atomics.notify 把它唤醒。听着很美好,但实战里这套"等待—唤醒"很容易写出死锁,尤其当你的 Worker 数量多起来、依赖关系变复杂时,排障基本靠玄学。我个人的经验是:共享内存只留给"纯数值并行计算"这种彼此不依赖顺序的场景,凡是涉及业务流程顺序的同步,老老实实回到 postMessage 的消息模型,虽然慢一点,但逻辑清清楚楚、好测好改。
七、兼容性与那些反人类的限制(坑 / 必须 / 验证)
讲完实战,必须把"坑"和"限制"摊开说,否则你写出来的代码在自己 Chrome 上跑得欢,一到用户那儿全废。核心就下面几条,建议逐条对照验证:
- Safari 完全不支持 SharedWorker(截至 Safari 17.6,iOS 全系无例外)。如果你的产品要覆盖苹果用户,SharedWorker 只能当可选优化,绝不能当核心通信机制。
- file:// 协议下基本都禁用,Worker 脚本必须通过 HTTP(S) 加载。本地开发记得起个本地服务器,别直接双击 html。
- origin 必须完全一致。http 和 https 算不同源,www 和非 www 也算不同源。我曾经就因为 dev 环境没带 www,两个标签页死活"共享"不上,查了半天才发现是 origin 不一致——SharedWorker 的"共享"是基于 URL 的隐式隔离,差一个字符就彻底隔离。
- SharedWorker 访问不了 localStorage、IndexedDB 这类存储 API,要从 Worker 读写存储,得通过 port 把请求转发给页面、由页面代理。
- query 参数不同视为不同实例。比如 shared-worker.js?v=1 和 shared-worker.js?v=2 在浏览器眼里是两个独立的 SharedWorker,别指望它们能共享。
还有一点老手都懂但新手必踩的:SharedWorker 实例的销毁时机你控制不了。页面关闭时对应的 port 会断开,但 SharedWorker 本身不会立刻死——只有所有连接都断开,浏览器才可能在某个不可控的时刻回收它。所以千万别在 SharedWorker 里放"只初始化一次就必须常驻"的关键状态,否则用户关了所有标签页再打开,发现之前的缓存没了,还以为是 Bug。把 SharedWorker 当成"无状态的消息中转站"最稳,真正要持久化的东西交给后端或 IndexedDB(通过页面代理去读写)。
怎么优雅降级?上线前一定要做能力探测,给不支持的浏览器一条活路:
javascript// 先探测浏览器到底能不能用 SharedWorkerif (typeof SharedWorker !== 'undefined') { // 能用就走共享线程方案 setupSharedWorker();} else { // Safari / iOS 没这玩意儿,降级到 BroadcastChannel 或各 tab 各起一个 Worker console.warn('当前浏览器不支持 SharedWorker,已降级处理'); setupFallback();}
说真的,每次写这种降级分支我都觉得啰嗦,但线上用户不会管你技术多酷,他们只在乎功能能不能用。把边界情况兜住,才是真·工程能力。
八、小结:什么时候该用,什么时候别碰
写了这么多,最后用"黑科技"的口吻总结一句:Web Workers 不是银弹,它是你主线程卡到没法忍时的逃生通道。判断要不要用,我给自己定了三条铁律:
- 该用:单任务执行超过几十毫秒的 CPU 密集型活儿——大数据排序、过滤、解析、图像像素处理、加密解密、音视频编码,果断丢进 Worker。
- 别碰:任务本身几毫秒就完事,或者必须频繁操作 DOM 的场景。Worker 碰不了 DOM,你硬要它改页面,只能绕回主线程,纯属脱裤子放屁。
- 想丝滑:把重计算搬走之后,主线程空出来了,路由切换、动画才能顺。配合View Transitions API 实战:给 SPA 路由切换加上丝滑的视图过渡动画这类视图层优化,整体体验才是真的"快而不卡"。
还有个容易忽略的取舍:Worker 不是越多越好。每个 Worker 都是实打实的线程,开几十个反而把 CPU 打满、上下文切换成本飙升。我的一般做法是"按任务类型建少量长期 Worker",比如一个专门算数据、一个专门处理图像,而不是来一个请求就 new 一个。需要并发就往同一个 Worker 里丢任务队列,让它内部串行或分片处理,这样线程数可控、内存可控、出问题时也只有一个地方要查。记住,多线程是手段不是目的,让产品更流畅才是。
回过头看,当年那个卡死三秒的数据看板,用 Web Workers 把过滤排序逻辑搬进后台线程之后,输入框打字如德芙般丝滑,用户再也没投诉过。技术没变多难,只是我把"计算"和"渲染"这两件本来该分开的事,终于分开干了。这大概就是多线程之于前端最朴素的价值:让主线程专心做它该做的事——把界面画好,把用户伺候好。
标签:javascript, 前端, 开发语言描述:本文以真实踩坑切入,系统讲清 Web Workers 与 SharedWorker 的多线程通信机制:从 Dedicated Worker 计算卸载、Transferable 零拷贝、SharedWorker 多标签页共享,到 SharedArrayBuffer+Atomics 共享内存与兼容性降级,附可运行代码与工程避坑清单,帮你把卡死主线程的 CPU 密集型任务真正丢给后台线程。



发表评论发布评论后审核成功,即可显示在列表中...