#Fetch+AbortController+Streams实战:现代请求的中断与流式读取(进度/取消)去年做一个"大文件下载+进度条+取消按钮"的需求时,我拍着胸脯跟产品经理说"这个简单,fetch一把梭就行"。…
Fetch + AbortController + Streams 实战:现代请求的中断与流式读取(进度/取消)
Fetch + AbortController + Streams 实战:现代请求的中断与流式读取(进度/取消)
去年做一个"大文件下载 + 进度条 + 取消按钮"的需求时,我拍着胸脯跟产品经理说"这个简单,fetch 一把梭就行"。结果上线第一天就被打脸。我做的取消按钮,点了之后进度条确实停了,UI 也安静了——可我抓包一看,底层的 TCP 连接还活着,后端文件还在往我这边哗哗地推,浏览器内存还在往上爬。更离谱的是后来做 AI 对话的"停止生成",我天真地以为调个什么方法就能让后端别再烧 token,折腾两天才发现,前端那点取消动作根本没传到服务端,模型该算还得算,账单该涨还得涨。
还有个更蠢的:我曾经用过一个第三方请求库,它的 cancel 方法只是把 Promise 标记成 resolved,底层根本没断。我还纳闷为什么取消之后网络面板里请求还是"pending 转圈",直到我去翻它的源码才恍然大悟——所谓取消,不过是把结果扔了而已。从那以后,我对任何封装的"取消"都先打个问号,非得确认它底层用的是 AbortController 或者真的关了连接才信。
这两个坑让我明白一件事:fetch 看起来是个"发请求"的简单 API,可一旦涉及"我要中途反悔""我要边下边看""我要知道下载到百分之多少",它就不再是调一个函数的事了。原生 fetch 压根没有 cancel 方法,也没有下载进度事件,想做这些,得靠 AbortController 去掐信号,靠 response.body 这条 ReadableStream 去一块一块地读。
我后来把这套东西在三个项目里反复踩坑、反复重写,才算摸透。这篇文章不是教科书,是我把踩过的坑、查过的 MDN、还有那几行改了又改的代码,摊开来讲一遍。你会看到:怎么用 AbortController 真正中断一个请求(以及它中断不了什么),怎么用 ReadableStream 把响应体流式读出来,怎么靠 Content-Length 算出一个像样的进度条,以及怎么把"取消"从"前端演戏"变成"前后端都收手"。
还有一个我当初死活想不通的点,先在这儿埋个伏笔:我第一版代码用的是 response.json() 去拿结果,还指望它能顺便告诉我下载进度。结果当然是没有进度,而且大文件直接把主线程卡成白屏——因为 json() 必须等整包到齐才解析。后来我才懂,要进度就得放弃 json()、text()、blob() 这些"等齐了再说"的方法,改用流式读取。这点后面第三节会细讲,但你先记住:要进度,就别用那些"一次性"方法。
先把我现在能下的结论摆出来,省得你跟我一样绕弯路:fetch 本身不支持取消,也不暴露进度;取消靠 AbortController 的 signal,进度靠 ReadableStream 的 getReader() 手动累计字节;而"取消请求"和"关掉读取"是两个独立动作,忘了关 reader,连接和资源照样漏。下面分模块讲,每个模块都给可运行的代码和中文注释。
一、先泼盆冷水:fetch 自己并不会"取消"
我一开始的直觉是:发个请求,想停就停呗,难道 API 连个 cancel 都没有?查了一圈才发现,Fetch API 的设计里根本没有 cancel 这个方法。它把"取消"这件事交给了一个独立的控制器——AbortController。
这个东西的逻辑特别朴素:你 new 一个控制器,它给你一个 signal(信号对象),你把 signal 塞进 fetch 的配置项里;之后你随时调 controller.abort(),fetch 那个 Promise 就会以 AbortError 这个名字被 reject 掉。就这么简单,但坑也就藏在"就这么简单"里。
javascript// ① 创建一个 AbortController 实例const controller = new AbortController();// ② 取出它的 signal,待会儿交给 fetchconst signal = controller.signal;// ③ 发起请求时,把 signal 塞进配置项fetch('/api/data', { signal }) .then((response) => response.json()) .catch((err) => { // ④ 取消会抛 AbortError,要跟真实网络错误区分开 if (err.name === 'AbortError') { console.log('请求被主动取消了'); } else { console.error('其他错误:', err); } });// ⑤ 在任意时机(用户点取消 / 超时 / 组件卸载)调用 abort// controller.abort();
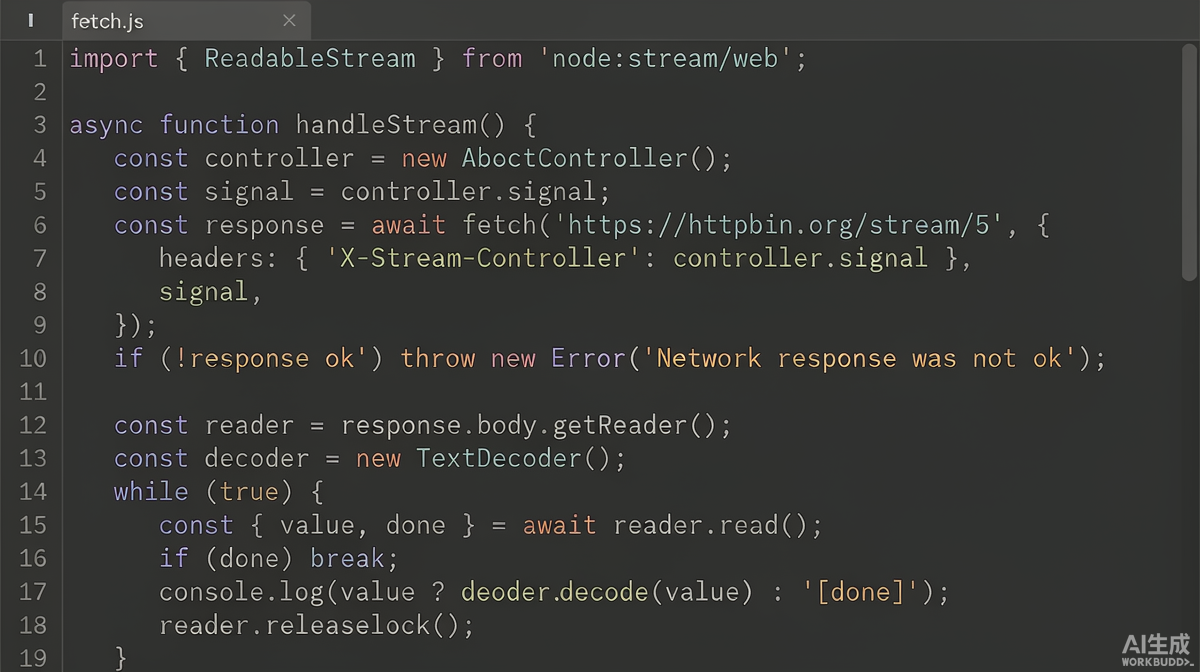
上面这段代码是地基。但我要吐槽一句:很多人(包括当年的我)以为调了 abort() 就万事大吉,连接一定被掐断、后端一定停手。现实没这么理想,这点我们下一节专门拆。
二、中断的本质:AbortController 到底能掐断什么
我踩的第一个真坑就在这里。AbortController 的 abort() 到底做了什么,取决于你调用它的时候,请求正处在哪个阶段。MDN 上也说得很克制,它不是一个"强制杀进程"的开关,而是一个"协作式取消信号"。
我把它分成三种情况记,省得迷糊:
- 请求还没真正发出去(还在 DNS 解析、TCP 握手阶段):abort() 直接放弃这次连接,干干净净。
- 请求已经发出,但服务端还没把响应头吐回来:浏览器会发 RST 包或者关掉 socket,效果上连接是断了。
- 响应头已经到了、响应体正在流式读取:abort() 会让底层的 ReadableStream 立刻进入 closed 或 errored 状态,你后续的 reader.read() 要么返回 { done: true },要么直接抛 AbortError。
看到没?前两种情况是真·断开连接,第三种情况严格说只是"JS 层不再处理",底层 TCP 是否立刻释放,还看浏览器和网络栈的心情。这也是为什么做 AI 流式对话时,光调前端 abort 不够——你只是不读了,服务端还在吐,得配合服务端感知断连(比如 Express、FastAPI、Spring WebFlux 都能监听 socket 关闭)才能真正停掉生成。
举个我踩过的真例子:有次我在一个已经拿到响应头的请求上 abort,满心以为连接断了,结果服务端日志显示它把整个响应体都发完了。因为那时响应头已到、流已开始,abort 只是让我的 reader 不再读,TCP 那头该发还是发。所以如果你的场景是"大响应体中途取消省带宽",光靠 abort 不够,必须配合 reader.cancel 让浏览器尽早关掉读取端,才能尽量早地让 TCP 不再接收。
我印象最深的一次,是线上一个导出报表的接口,用户点了取消,前端进度条归零,我以为万事大吉。结果运维跑来跟我说,那台应用服务器 CPU 还在 100% 跑,因为后端还在拼那个几百万行的 CSV。那一刻我才彻底理解:前端的 abort 只是"我不听了",不是"你别说了"。真正要让后端停,得后端也监听连接断开。这点认知,值我半天的故障复盘。
说到这里,想起一个真实场景:我用Performance API 实战:用 Navigation/Resource Timing 做前端性能监控(Web Vitals)里提到的Resource Timing 去量一个被取消的请求,才发现 abort 之后那条连接在浏览器计时里并不等于"彻底释放",监控看到的耗时和真实释放是两码事,别被面板上的数字骗了。
还有个常被忽略的点:AbortController 本身不自动销毁,它只是个信号发射器。如果外面一直拿着它的引用,它就不会被 GC。所以别把它挂到全局然后忘了清,我见过有人把 controller 塞进一个单例里再也不 abort,结果页面切来切去攒了一堆"僵尸信号"。
三、流式读取:response.body 才是真正的宝藏
如果你只用过 response.json()、response.text()、response.blob(),那我要提醒你:这三个方法都会"等全部到齐"才给你结果。大文件、长连接、AI 流式输出,你用它们就只能干瞪眼等。想要"边下边处理",得用 response.body。
response.body 是一个 ReadableStream。你调 response.body.getReader() 拿一个 reader,然后用 while 循环不断 reader.read(),每次拿到一个 { value, done }:value 是一段 Uint8Array(原始字节),done 为 true 时说明流结束了。
Streams API 这套"拉取"模型(你主动 read,流才给你数据)跟传统的"推送"模型(比如 addEventListener 等事件)思路是反着的。我刚接触时老想写个 onData 回调,结果发现根本没这回事,得自己写 while 循环去拉。习惯之后反而觉得拉取模型更可控——至少背压(backpressure)这事你看得见:流内部队列满了,read 就会自然地慢下来,不会像事件那样把你淹没。
javascript// 一个安全的流式读取封装(SSE / 实时日志 / 大文件都通用)let controller = null;let reader = null;async function startStream(url) { // ① 每个请求都新建一个控制器,别复用 controller = new AbortController(); try { const res = await fetch(url, { signal: controller.signal }); if (!res.ok) throw new Error(`HTTP ${res.status}`); // ② 拿到流的 reader,开始一块一块读 reader = res.body.getReader(); while (true) { const { value, done } = await reader.read(); if (done) break; // ③ 流自然结束 // ④ 处理这一块数据,比如用 TextDecoder 解码成文本 // console.log(new TextDecoder().decode(value)); } } catch (err) { // ⑤ 取消会抛 AbortError,单独识别,别当普通错误处理 if (err.name === 'AbortError') { console.log('请求已被取消'); } else { console.error('流读取异常', err); } } finally { // ⑥ 无论如何都主动 cancel,释放流资源,别留尾巴 if (reader) { await reader.cancel(); reader = null; } }}// 用户点"停止"时调用,掐断请求和读取function stopStream() { if (controller) controller.abort();}
我得强调 finally 里的 reader.cancel()。我当年漏了这一句,结果流没释放,反复进页面反复发请求,内存蹭蹭涨,DevTools 的 Memory 面板一看全是没回收的 ArrayBuffer,那叫一个尴尬。
另外,中文场景一定要用 new TextDecoder('utf-8', { stream: true })。为什么?因为一次 read() 拿到的 value 可能正好把一个多字节汉字从中间截断,普通 decode 会出乱码。加上 stream: true,decoder 会替你缓存半个字符,等下一块拼上再解码。这个细节,MDN 的 TextDecoder文档专门提到过,我踩过乱码坑之后才真正记住,而不是抄完代码就跑。
加一句实在的:流式读取最香的用法其实是"实时日志"和"AI 打字机"。我做过一个看容器日志的页面,后端用类似 SSE 的流一直推,前端边收边 append 到文本框,十几万行也不卡,因为从来不攒完整字符串。换成 text() 那种等齐了再渲染,页面早死了。这就是 getReader 循环存在的意义——它把"等"变成了"边走边看"。
四、进度条:Content-Length + 累计字节才是正解
产品经理要的"下载到 87%"那种进度条,fetch 可没给你现成的。它不像 XMLHttpRequest 有 progress 事件——XHR 能监听上传和下载进度,fetch 连上传进度都监听不了,这是它的硬伤。但 fetch 把响应体交给我们自己读之后,进度反而可以自己算:
思路很简单:先看响应头里有没有 Content-Length(这是文件总字节数),然后每次 reader.read() 拿到 value,就把 value.length 累加到"已接收字节数",两者一除就是百分比。
javascript// 用 getReader 手动累计字节,算出一个真实进度async function downloadWithProgress(url, onProgress) { const response = await fetch(url); // ① 从响应头拿总大小;没有的话后面只能显示"不确定进度" const total = Number(response.headers.get('Content-Length')) || 0; const reader = response.body.getReader(); let received = 0; // 已接收字节数 const chunks = []; // 收集每一块,最后拼成完整文件 while (true) { const { done, value } = await reader.read(); if (done) break; chunks.push(value); received += value.length; // ② 回调进度;total 为 0 时无法算百分比 if (total) { onProgress(Math.floor((received / total) * 100)); } } // ③ 把所有块拼成一个 Uint8Array,再交给 Blob const all = new Uint8Array(received); let pos = 0; for (const chunk of chunks) { all.set(chunk, pos); pos += chunk.length; } return new Blob([all], { type: response.headers.get('content-type') || 'application/octet-stream' });}
几个我踩过的坑,写在这儿提醒你:
- 没有 Content-Length 时,别硬算。常见于分块传输(chunked)、代理转发、或者某些后端框架。这种情况只能显示"正在下载…"或者用
<progress indeterminate>那种不确定进度条。 - 进度回调一定要节流。我最早没节流,每收到一块(可能几十毫秒一次)就 setState,React 直接被我刷崩了。建议每 50ms 最多触发一次。
- 收到 Blob 之后,想触发浏览器下载就用 URL.createObjectURL 加一个隐藏
<a>的 click,下载完记得 URL.revokeObjectURL 释放,不然内存又漏了——对,又是我干过的事。
再补一个我后来才用的进阶技巧:如果服务端支持 Range 请求,你甚至可以分片下载,每个分片独立发 fetch、独立算进度,最后按顺序拼起来。这样既能断点续传,又能绕开"没有 Content-Length"的窘境——因为你自己决定每一片多大。当然,这要求后端配合,不是前端单方面能搞定的。我在一个视频点播项目里这么干过,体验比傻等一个超大响应体好太多。
还有一个细节容易忘:Content-Length 返回的是字符串,必须 Number() 转成数字再算;我第一次直接拿字符串相除,结果是 NaN,进度条永远 0%,排查了十分钟才发现是类型问题。所以示例里我特意写了 Number(...) || 0,既转类型又兜底缺失。这种"看着像数字其实不是"的坑,在处理响应头时特别常见,记住这一条能省你不少调试时间。
如果你想把"解码 / 解析这些大块数据"这种重活从主线程挪走,可以看看 Web Workers 实战:把计算密集型任务丢给后台线程(SharedWorker 与多线程通信),把 reader 读到的 chunk 丢给 Worker 去处理,主线程的进度条才不会卡成幻灯片。
五、管道玩法:pipeTo + TransformStream 边读边写
上一节的写法适合"读进来再拼文件"。但如果你是要边下载边保存(比如写入 IndexedDB,或者用 File System Access API 直接落盘),一点点拼数组再一次性 Blob 太浪费内存。这时候该上管道了。
TransformStream 是个中间件:数据从 response.body 流进来,经过它的 transform 方法,你在这里既能统计进度,又能把数据原样 enqueue 给下游。下游可以是一个 WritableStream,比如文件的写入流。
javascript// 用 pipeTo + TransformStream 实现边读边写 + 进度统计async function pipeWithProgress(url, fileHandle, onProgress) { const response = await fetch(url); const total = Number(response.headers.get('Content-Length')) || 0; let received = 0; // ① 建一个 TransformStream 作为"进度统计中间件" const transform = new TransformStream({ transform(chunk, controller) { received += chunk.byteLength; // ② 每块累加字节 if (total) onProgress(Math.floor((received / total) * 100)); controller.enqueue(chunk); // ③ 原样往下游传 }, }); // ④ 把响应体管道到 TransformStream,再管道到可写流 await response.body .pipeTo(transform.writable) .then(() => fileHandle.createWritable()) .then((writable) => transform.readable.pipeTo(writable));}
顺带说,TransformStream 不只是用来统计进度的。它本质上是"数据的中转站",你可以在 transform 里做任何转换:解压缩、格式转换、甚至边读边给数据做哈希校验。我见过有人用它实现"边下载边解密",流进来的时候还是密文,流出去的时候已经是明文,内存里从没出现过完整的解密后文件,安全性拉满。不过话说回来,能力越强越容易写错,管道一旦接错方向,debug 起来比 while 循环还头疼。
这里有个重要的坑:pipeTo 一旦开始,是不可中断的(至少不像我们前面那样随便 abort 就停)。错误得靠监听或者 catch 来兜底。而且注意我上面写法里 TransformStream 的用法——它把"统计"和"传递"耦合在一起,比手动 while 循环优雅,但调试也更绕。
Streams API 这套管道思想是 MDN Streams API 里讲得最系统的,建议配合着看,别像我一样只抄代码片段结果管道方向接反了,数据没写进去还查了半天才发现是 writable 和 readable 搞混。
六、现代写法:把 signal 直接喂给 reader.read()
前面几节我们都是靠 try/catch 抓 AbortError 来感知取消。但较新的浏览器给了更优雅的写法:你可以直接把 signal 传给 reader.read(),或者在 signal 上监听 abort 事件主动 cancel reader。
javascript// 写法 A:监听 signal 的 abort 事件,主动取消 readerconst reader = response.body.getReader();signal.addEventListener('abort', () => { reader.cancel().catch(() => {}); // 信号一断,立刻停读});while (true) { const { done, value } = await reader.read(); if (done) break; // 处理 chunk}// 写法 B(更现代):把 signal 直接塞给 read(),浏览器自己会在中断时抛出 AbortError// Chrome 126+、Firefox 128+ 支持,老浏览器会当普通参数忽略const { done, value } = await reader.read({ signal });
写法 B 是真香,少写好几行。但支持度有门槛:reader.read({ signal }) 是较新的能力,caniuse 上 AbortController 能查到大致的兼容范围,新项目可以放心用,要兼容老浏览器就退回写法 A 加监听事件。我个人的做法:新项目直接写法 B,但要写个注释说明兼容边界,免得半年后接手的人骂我。
对了,View Transitions API 实战:给 SPA 路由切换加上丝滑的视图过渡动画 里那种丝滑切换,跟我这儿的"加载中 → 进度更新 → 完成"状态切换其实是一路人——都是把"等待"这件事做得不那么让用户烦躁。进度条本身,就是一种对用户焦虑的安抚。
七、内存与清理:别让流变成漏勺
我前面反复提"释放""清理",不是啰嗦,是因为流式读取最容易悄悄漏内存。几个要点:
- reader.cancel(reason) 会终止流、拒绝当前和后续的 read(),适合"主动停止"场景。
- reader.releaseLock() 只是解除 reader 对流的独占,不终止流;而且调完就不能再 read() 了,得确保真的不读了才用。
- 推荐顺序:先 reader.cancel() 做清理,再处理状态重置。
- 不要复用同一个 AbortController。每次新请求 new 一个,复用会导致旧请求被新请求的 abort 误伤——这个 bug 我 debug 了一下午,记忆犹新。
- React 项目里,useEffect 的清理函数里调 controller.abort(),组件卸载时自动收手,省心。
再啰嗦一个隐蔽的:reader 用完如果不 cancel 也不 releaseLock,这个 reader 会一直"锁"着那条流,导致你没法再 getReader,也没法 pipeTo,报错还特别迷惑(类似"ReadableStreamReader 已被锁定")。我第一次遇到时以为是浏览器 bug,查了半天才发现是自己没释放。所以记住一句话:流是稀缺资源,用完即还。
还有那个老朋友 URL.revokeObjectURL,再提一次:Blob URL 用完一定要 revoke,不然页面开久了内存就是一条向上的斜线。我承认这些"记得清理"的教训,几乎每一个都对应着一次线上内存报警,说多了都是泪。
八、组合实战:一个能取消、带进度、还能分享的下载封装
把前面所有点揉在一起,我给你一个我现在在用的"全家桶"封装:既能取消,又能报进度,下完还能直接调系统分享面板把文件发出去。
javascript// 可取消 + 带进度 + 下载完成后可分享的封装async function smartDownload(url, { onProgress, signal } = {}) { // ① 外部没给 signal 就自己建一个,方便返回出去供调用方取消 const controller = new AbortController(); if (signal) { if (signal.aborted) controller.abort(); else signal.addEventListener('abort', () => controller.abort()); } const response = await fetch(url, { signal: controller.signal }); const total = Number(response.headers.get('Content-Length')) || 0; const reader = response.body.getReader(); let received = 0; const chunks = []; try { while (true) { // ② 现代写法:把 signal 直接传进 read const { done, value } = await reader.read({ signal: controller.signal }); if (done) break; chunks.push(value); received += value.length; if (total) onProgress(Math.floor((received / total) * 100)); } } catch (err) { if (err.name !== 'AbortError') throw err; // 主动取消静默处理 return null; } // ③ 拼成 Blob 并触发下载 const blob = new Blob(chunks); const objUrl = URL.createObjectURL(blob); // ... a.click() 下载 ... URL.revokeObjectURL(objUrl); // ④ 若支持 Web Share API,可直接把文件分享出去 if (navigator.canShare && navigator.canShare({ files: [new File([blob], 'file')] })) { await navigator.share({ files: [new File([blob], 'download.bin')] }); } return blob;}
这个封装不是一天写出来的。我前两版要么忘了把外部 signal 转发,要么在 catch 里把 AbortError 当异常处理导致上报了一堆"错误"。现在的版本把"主动取消"当成正常路径静默返回 null,只有非 AbortError 才往上抛——这样你的错误监控不会被取消操作污染。说实话,能把取消和错误分得这么清,是因为我被误报的告警短信吵醒过不止一次。
调用方只要握着返回的 controller(或传进来的 signal),随时 abort 就能掐断;onProgress 拿到百分比去更新进度条;下完还能顺手用 Web Share API 实战:调用浏览器原生分享面板(Web Share Target 接入) 里讲的 navigator.share 把文件甩给微信、隔空投送之类。一个封装,三件事全齐。
小结:别再把"取消"当演戏
回头看,我最早那个"假取消"的 bug,根子在认知:以为调个方法就等于一切停了。其实前端这套取消是协作式的——你发信号,fetch、reader、服务端各自选择要不要听。
我给你划几个重点,记不住就回来翻:
- fetch 没有 cancel,取消靠 AbortController 的 signal;务必区分 AbortError 和真实错误。
- abort() 不一定杀得掉底层 TCP,它中断不了已建立的流读取,得另外 reader.cancel()。
- 进度只能自己算:Content-Length 作分母,累加 chunk.length 作分子;没有 Content-Length 就老老实实显示不确定进度。
- 流式读取用 response.body.getReader() 循环 read;中文务必 TextDecoder('utf-8', { stream: true })。
- 现代浏览器支持 reader.read({ signal }),代码更干净,但注意兼容边界,老浏览器退回监听 abort 事件。
- finally 里释放 reader,组件卸载时 abort,别复用 controller,别忘 revokeObjectURL。
如果你问我这套东西值不值得花时间学,我的答案是:只要你写过任何一个"等得比较久"的请求,就值得。下载、上传(虽然 fetch 上传没进度)、AI 流式对话、大文件预览,哪一个都离不开 AbortController 和 Streams。它们是现代前端处理"网络不确定性"的两条腿,少一条都走不稳。
这些点,MDN 的 AbortController和ReadableStream 文档都讲得比我细,但我踩过的坑、写错的代码,是文档里没有的。希望你看完,少走我走过的弯路,别再让取消按钮变成只是个遮住 UI 的障眼法。
标签:javascript, 前端, 开发语言描述:系统讲透 fetch 原生不支持取消与进度的真相:用 AbortController 掐断请求、用 ReadableStream 流式读取并按 Content-Length 计算进度、用 reader.cancel 真正释放资源,附可运行中文注释代码与多个工程踩坑,帮你把"取消"从前端演戏变成前后端都收手。



发表评论发布评论后审核成功,即可显示在列表中...